필드로봇 피지컬 AI 파운데이션 모델 탐색 연구 — 최종 평가 발표2026년도 기본사업 최종 평가 · NK264F
필드로봇 피지컬 AI
파운데이션 모델 탐색 연구
이한민
한국기계연구원 산업기계DX연구실
01
서론 ① 연구 배경 — 정책 동향
피지컬 AI 투자, 실내에서 야외 필드로 확장
 실내제조 · 물류
 야외 필드재난 · 국방 · 농업
국가 전략피지컬 AI 1등 국가새정부 경제성장전략에 목표 명시 · 육성 추진
산업 수요필드로봇 중심 국가전략화김제 국회포럼 등 · 피지컬 AI 산업
시사점야외 필드 선점국가 핵심 전략 부합 · 신흥 공백 영역
02
서론 ② 연구 배경 — 기술 동향
해외는 파운데이션 모델 경쟁 · 국내 필드 적용은 공백
해외
Physical Intelligenceπ 계열 VLA다양한 로봇의 범용 제어 실증 NVIDIAGR00T 오픈 VLA휴머노이드 파운데이션 모델 가속화 FieldAIFFM필드 환경 특화 모델 개발 선도 국내
 이번 연구굴착기에 적용해 확인현황필드 적용 사례 전무
실내외 로봇 파운데이션 모델 연구 부족
03
서론 ③ 연구 필요성
필드 특화 모델 탐색과 데이터 기반 구축이 먼저
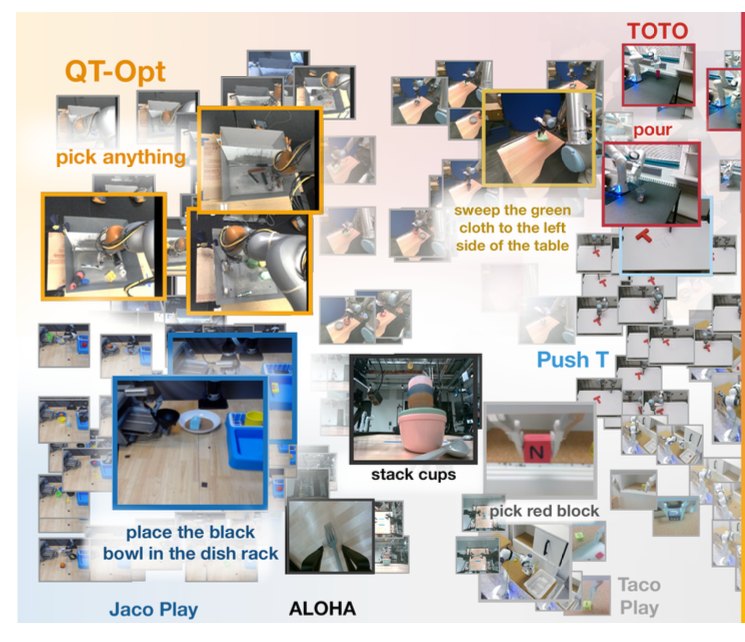
 실내 로봇팔정형 환경
+50 %범용 모델 > 전용 모델평균 성능 우위 (RT-X)
공개 자료 풍부 · 로봇 22종 · 100만+ 궤적
야외 필드 중장비극한 환경데이터 공백필드 특화 데이터셋 부재기존 학습 데이터와 분포 불일치
비정형 지형 · 조명 변화 · 통신 불안정
04
1. 과제 목표와 달성
계획한 네 가지 목표를 시뮬레이터 실증까지 수행 · 굴착기가 스스로 파는 단계까지 확인
| 계획서 목표 | 수행 결과 | 상태 |
|---|
| ① VLA 2종 비교 · 필드 적합성 평가 | GR00T N1.7 · π0.5 구조와 입출력 비교, 직접 실행해 확인 | 완료 |
| ② 굴착 관측–행동 시범 데이터셋 | 굴착 관측-행동 데이터셋 정의 및 시범 수집 → 표준 형식 변환 → 학습 및 검증 완료 | 완료 |
| ③ 모델 적용 실험 · 정량 지표 | 제로샷 확인 및 파인튜닝 후 성능 검증 완료(버킷 이동, 굴착, 관로) | 완료 |
| ④ 5년 로드맵 · 2027 전략과제 기획 | 5년 로드맵 작성 완료 및 2027년 전략연구사업 과제 수주 완료 | 완료 |
| 성과물 | 논문 1건 게재 / 기술보고서 1건 완료 / 소프트웨어 등록 1건 신청 | 완료 |
06
2. 공개 VLA 모델 2종 — 비교하고 직접 실행
둘 다 영상 + 지시문 → 행동 묶음 · 공식 로봇팔 과제는 두 모델 10/10 재현
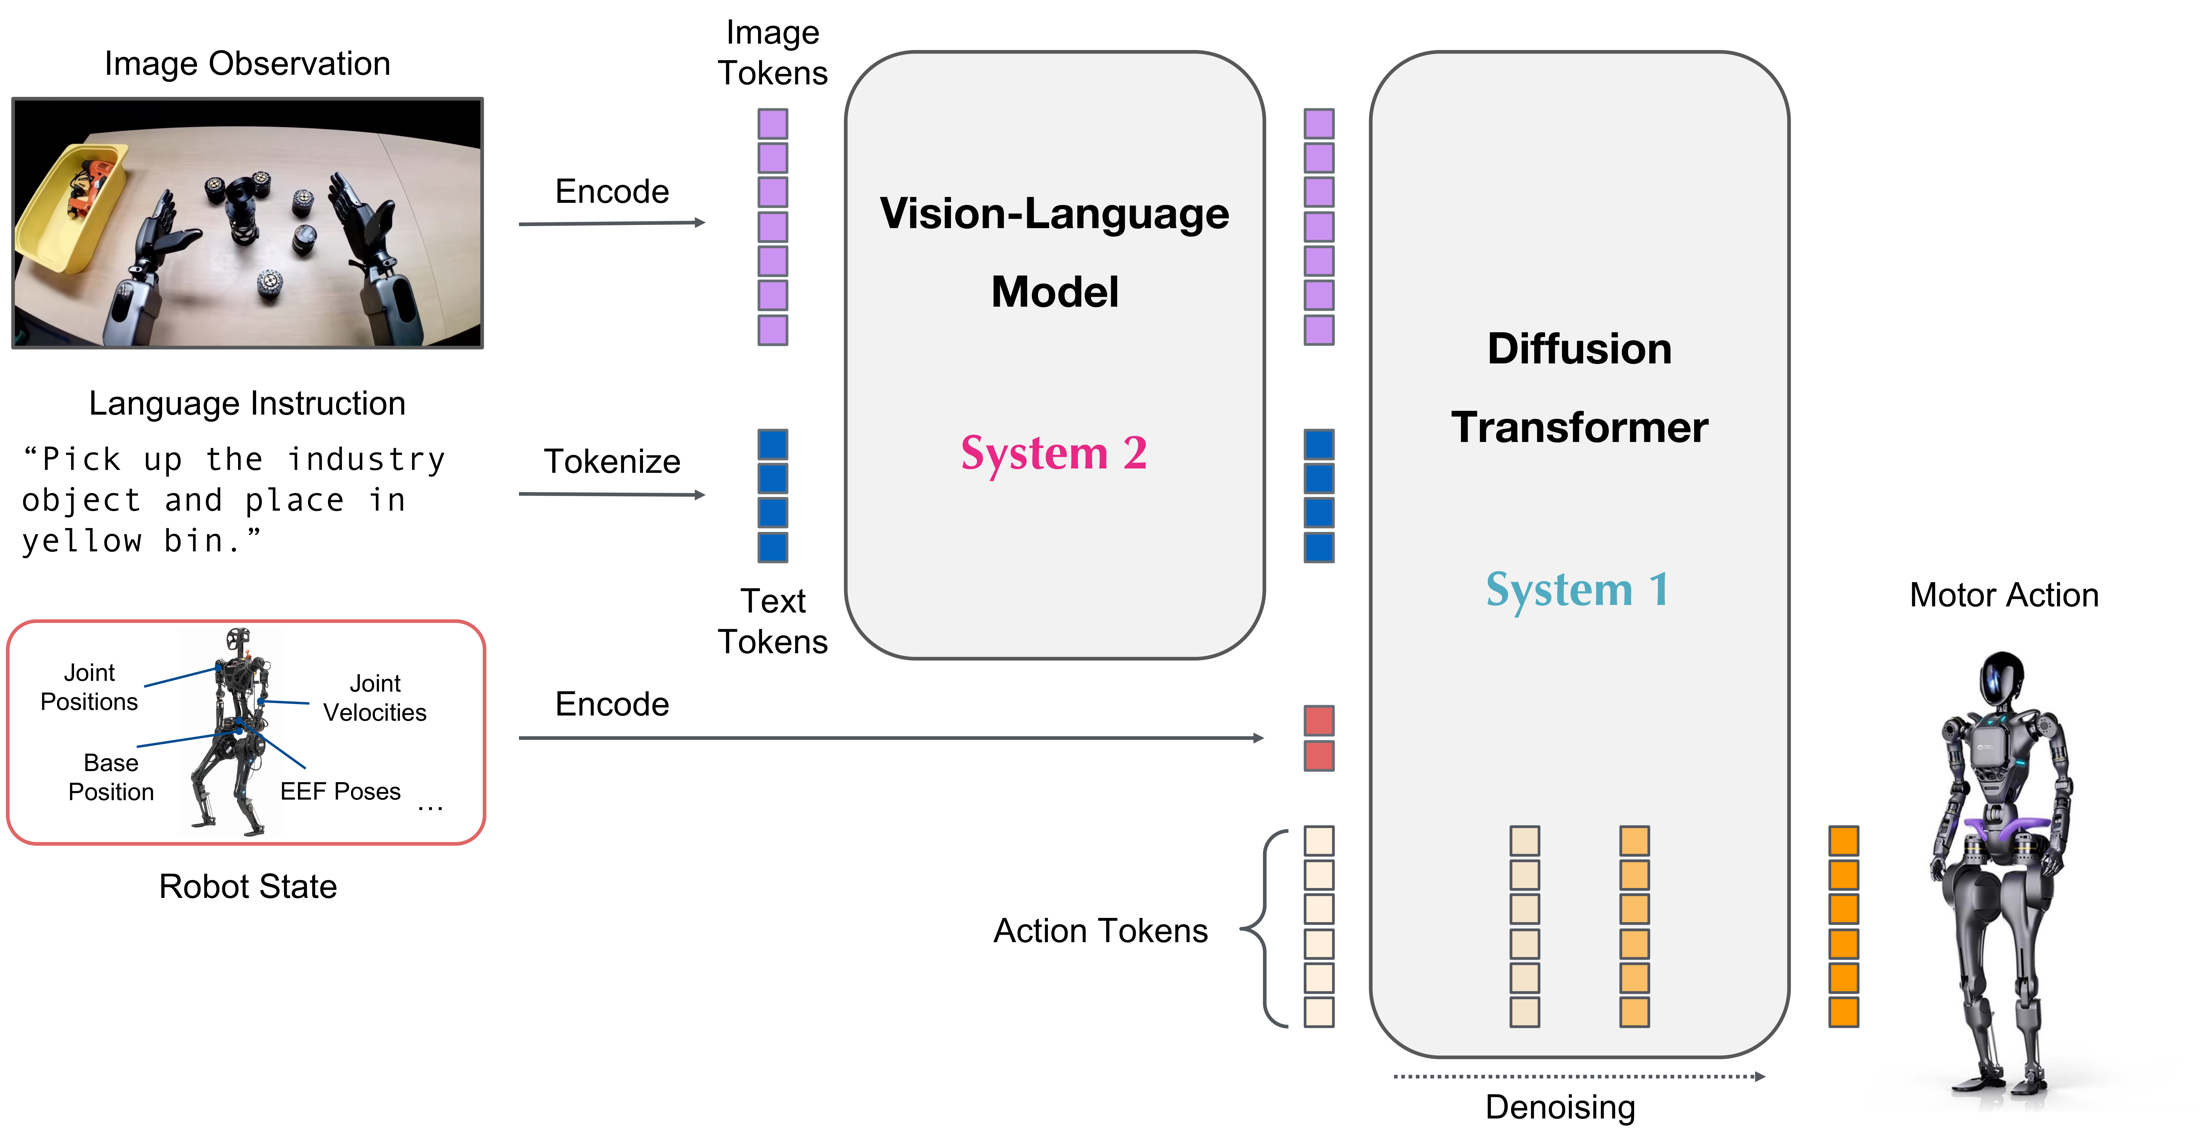
GR00T N1.7 (NVIDIA)
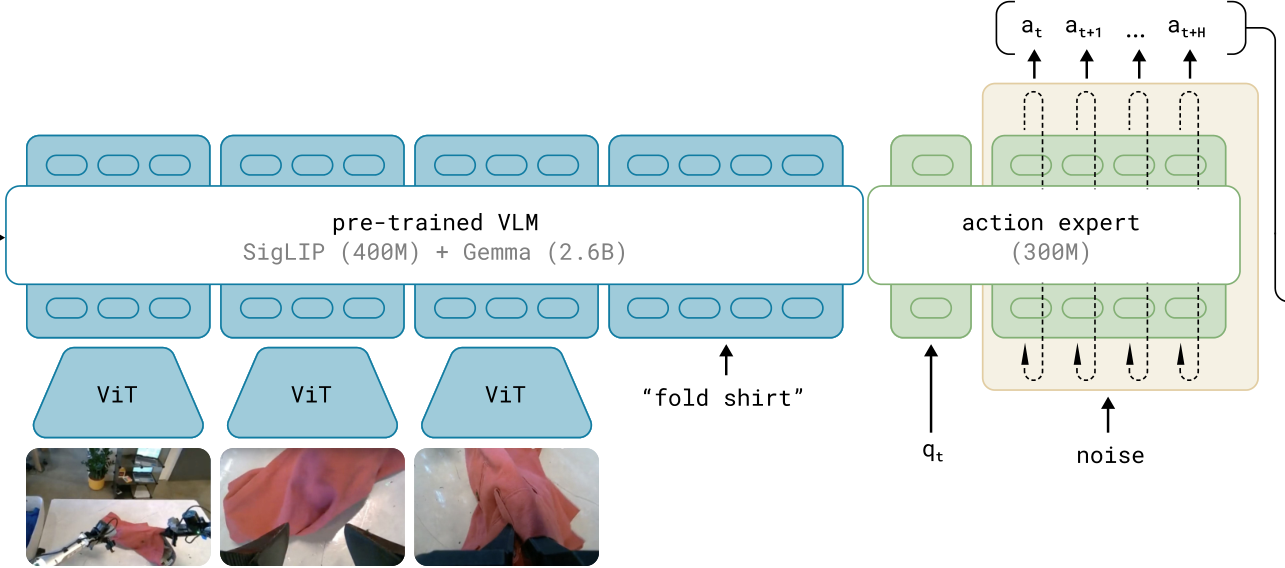
π0.5 (Physical Intelligence)
| GR00T N1.7 | π0.5 |
|---|
| 행동 생성 | 시각·언어 모델 + 확산 액션 헤드 | 시각·언어 모델 + 액션 전문가(흐름 정합) |
| 굴착기에 맞추기 | 새 기체 등록 후 투영층·헤드 학습 | LoRA 학습 |
| 추론 지연* | 중앙 91 ms | 중앙 110 ms |
* RTX 5080 16 GB · Intel Core Ultra 9 285K · RAM 64 GB
07
3. 필드 적합성을 위한 평가 체계 구축
넘어야 하는 관문 4 → 얼마나 잘하는지 비교 축 4
관문 G1–G4
G1적응 가능성새 장비로 학습 가능 여부
G2입출력·제어 계층관측 입력 · 명령 출력 연결
G3시간 정합명령 시점 · 계산 지연
G4안전 계층 결합제한·비상 정지 아래 안전
비교 축 P1–P4
P1작업 성능버킷 이동 · 굴착 · 관로 성공
P2일반화·강건성처음 보는 위치·지형 성공
P3데이터 요구·수집시범의 양 · 품질 · 수집 방법
P4계산 자원추론 지연 · 학습 자원
08
4. 두 모델의 필드 적합성 판정
두 모델 모두 학습 후 조건부 통과 · 안전 계층과 데이터·자원 비교는 미판정
| 기준 | GR00T N1.7 | π0.5 |
|---|
| G1적응 가능성 | 조건부조건부 통과접근 승인·라이선스 확인 | 조건부조건부 통과이용약관 확인 |
| G2입출력·제어 계층 | 조건부학습 후 조건부 통과무학습 불가 · 유압 제외 | 조건부학습 후 조건부 통과무학습 불가 · 유압 제외 |
| G3시간 정합 | 충족보정 후 충족굴착은 계산 중 시뮬레이터 정지 조건 | 충족보정 후 충족연속 굴착에서 계산 시간 누적이 더 큼 |
| G4안전 계층 결합 | 미판정미판정명령 크기 제한·감시 아래에서만 운전 | 미판정미판정 |
| P1작업 성능 | 버킷 이동 6/6굴착 네 동작 연속 운전 | 버킷 이동 6/6굴착 네 동작 연속 운전 |
| P2일반화·강건성 | 처음 보는 위치 4/8방향은 맞고 크기 부족 | 처음 보는 위치 6/8같은 양상 |
| P3데이터 요구·수집 | 미판정미판정 | 미판정미판정 |
| P4계산 자원 | 미판정미판정 | 미판정미판정 |
시뮬레이터 · 유압 제외 조건 · 조건당 시행은 대부분 1회
09
5. 관측–행동 공통 규격 — 수집 자료와 전달 형식
카메라 2대 + 관절 상태 + 지시문 → 4관절 속도 명령 8칸 묶음 · 표준 형식 LeRobot v2.1로 두 모델에 같은 자료
 버킷암붐선회
| 구분 | 내용 |
|---|
| 관측 · 영상 | 운전석 · 붐 RGB 2대 (640×480 기록 → 모델 입력 224) |
| 관측 · 상태 | 4관절(선회 · 붐 · 암 · 버킷) 각도 4 + 속도 4 |
| 지시문 | 동작별 문장 1개 (예: 관입 · 끌기 · 닫기 · 올리기, 스스로 전환은 1문장) |
| 행동 | 4관절 속도 명령 [−1, 1] × 8칸 묶음 · 좌표·목표 입력 없음 |
| 주기 · 동기 | 5 Hz 한 시각축 · 명령은 관측 뒤 요청값(인과) |
| 저장 형식 | LeRobot v2.1 (영상 mp4 + 표 + modality.json) → GR00T 새 기체 슬롯 · π0.5 상태 숫자 토큰 |
| 관로 단계 | + 지형 높이 지도 그림을 세 번째 영상으로 |
10
6. 두 모델의 입력과 출력
입력은 영상 + 지시문 (+ 상태) · 출력은 시간 × 7차원 행동 묶음
11
7. 학습 없이 굴착기에 그대로 — 제로샷
72회 시도 · 표적 0.5 m 안 도달 0회 → 굴착기 자료로 추가학습 필요
12
8. 시뮬레이터에서 시범 자료 뽑기
ROS 2 토픽을 듣기만 하는 기록기로 받아 영상·상태·명령을 한 시각축에 기록
13
9. 학습 자료 — 세 단계로 확대
쉬운 것부터 · 버킷 이동 → 굴착 → 전체 사이클
14
10. 단계별 학습 자료량 — 시범 횟수
단계마다 교사 시범 수십 회 규모로 추가학습 · 두 모델은 같은 자료 사용
① 버킷 이동
32회 시범
학습 구간 1,610
처음 24회 + 보충 8회
② 단계별 굴착
15곳 흙 위치 시범
학습 구간 1,996
처음 3곳 + 끌기 보강 12곳
③ 스스로 동작 전환
0회 추가 수집
②의 시범을 이어 붙여 재사용
학습 구간 2,192
④ 굴착 지점 스스로 (관로)
60회 시범 (3차 · 최대)
1차 30회 → 2차 +16회
3차 60회 재수집 → 4차 32회 재수집
학습 구간 2,057 → 3,953 → 7,531 → 3,543
시범 = 규칙 제어기(교사)가 시뮬레이터에서 자동으로 한 번 운전한 기록 · 학습 구간 = 관측 1시점 + 뒤따르는 행동 8칸 · 관로 4차 32회 = 학습 28 + 검증 4
15
11. 시범을 모아 학습 — 버킷이 표적까지 이동
학습 후 검증 위치 두 모델 6/6 · 시험 위치 7/8 · 처음 보는 위치 4/8 · 6/8
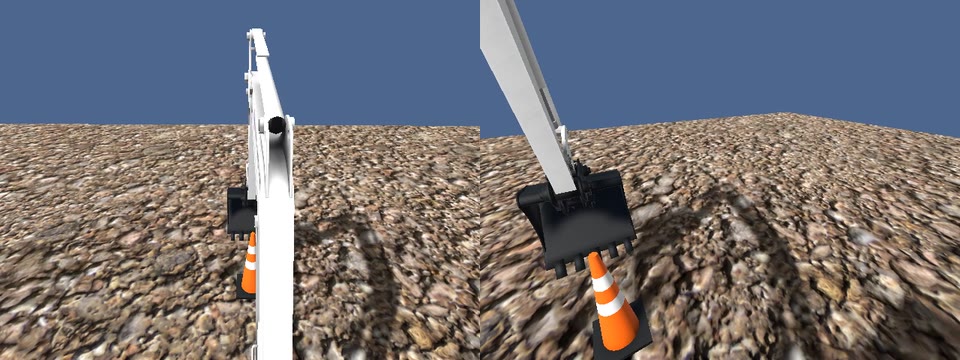
GR00T · 꼬깔콘 · 시험 위치 성공
최소 거리0.30 m
π0.5 · 꼬깔콘 · 시험 위치 성공

최소 거리0.18 m
GR00T · 꼬깔콘 · 위치 6 성공
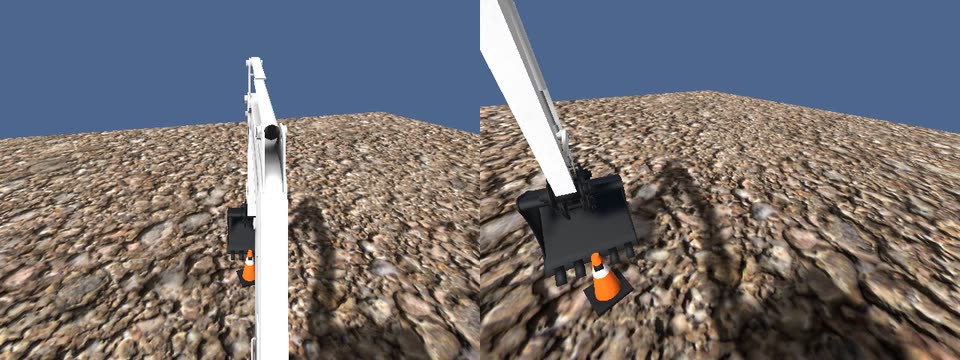
검증 위치 · 콘0.04 m
16
12. 굴착 ① 준비 — 네 동작으로 나눠 학습
관입 → 끌기 → 닫기 → 올리기 · 동작마다 성공 기준을 미리 정하고 한 모델에 학습

17
13. 굴착 ② 결과 — 네 동작을 하나씩
두 모델 모두 관입 · 끌기 · 닫기 · 올리기 네 동작 성공
관입
끌기
닫기
올리기
GR00T4/4
깊이 6.1 cm성공

흙 3.8 kg성공

13.0 kg성공
18.3 kg성공
π0.54/4
관입성공
흙 5.5 kg성공
14.4 kg성공
17.8 kg성공
18
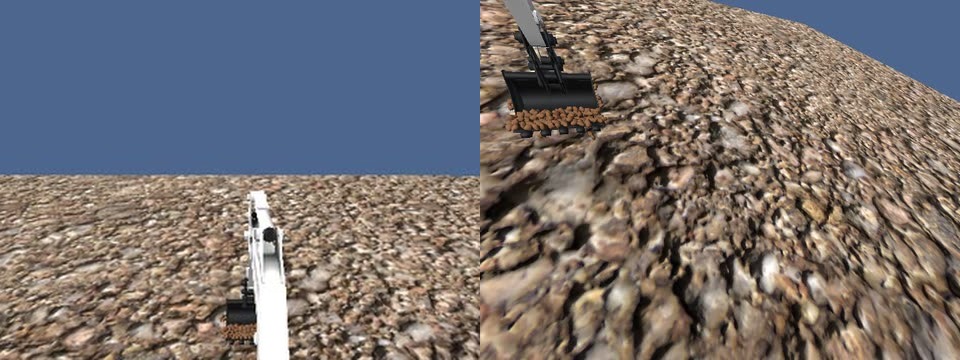
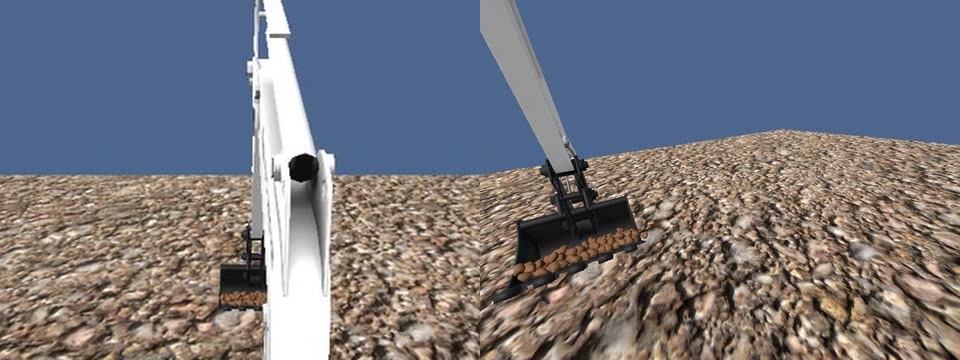
14. 굴착 ③ 네 동작 연속 굴착 — 지시문 하나로 스스로 전환
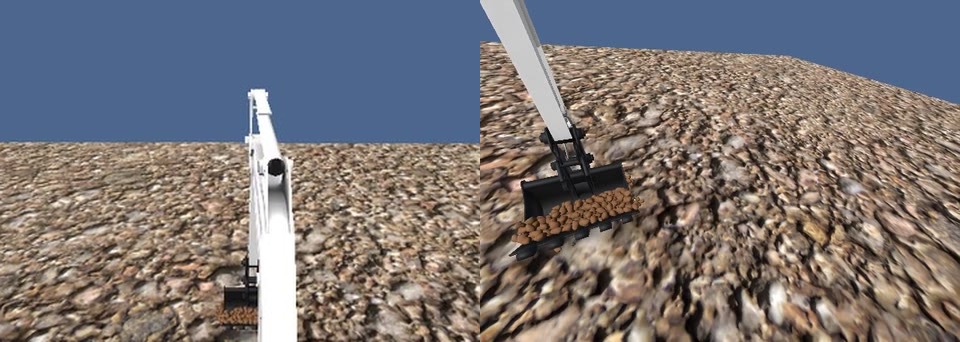
지시문 하나만 주면 모델이 관입 → 끌기 → 닫기 → 올리기를 스스로 이어 감 · 두 모델 완주
GR00T
π0.5
19
15. 굴착 지점 ① 준비 — 카메라에 라이다 지도 추가
모델 입력 = 카메라 2대 + 라이다로 만든 2D 높이 격자 지도 · 다음 팔 곳은 규칙으로 정한 시범을 학습
↓GR00T · π0.5→4관절 명령
20
16. 굴착 지점 ② 관로 1~4차 — 시범 수정 반복
접근 성공 → 진입 부족 → 시범 수정 → 진입 해결 · 실제 굴착 확인
1·2차접근 성공
3차진입 부족
3차 통과 실행실제 굴착
4차진입 해결 · 통과 4/12
21
17. 목표 ④ 5년 로드맵
2026 탐색 → 2027–2029 기반기술 확보 → 2030–2031 플랫폼 고도화·확장
2026탐색 (이번 과제)공개 VLA 2종 굴착기 적용
데이터 규격 · 학습 · 평가 절차
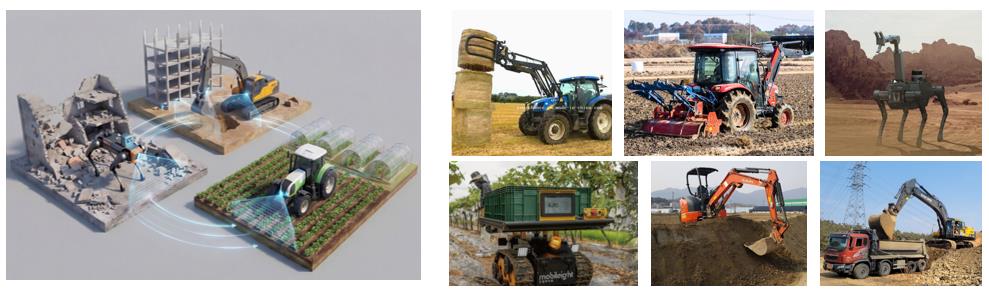
2027 – 20291단계 기반기술 확보재난·농업·건설 필드 데이터셋 · 디지털트윈
필드환경 인지 파운데이션 모델
장착형 자율화 모듈
2030 – 20312단계 플랫폼 고도화·확장장비·작업별 전문가 AI 라이브러리
소량 자료로 새 장비 적응
이기종 5종 필드로봇 레벨 4 실증
3년차필드환경 인지 파운데이션 모델 + 주행작업 전문가 모델
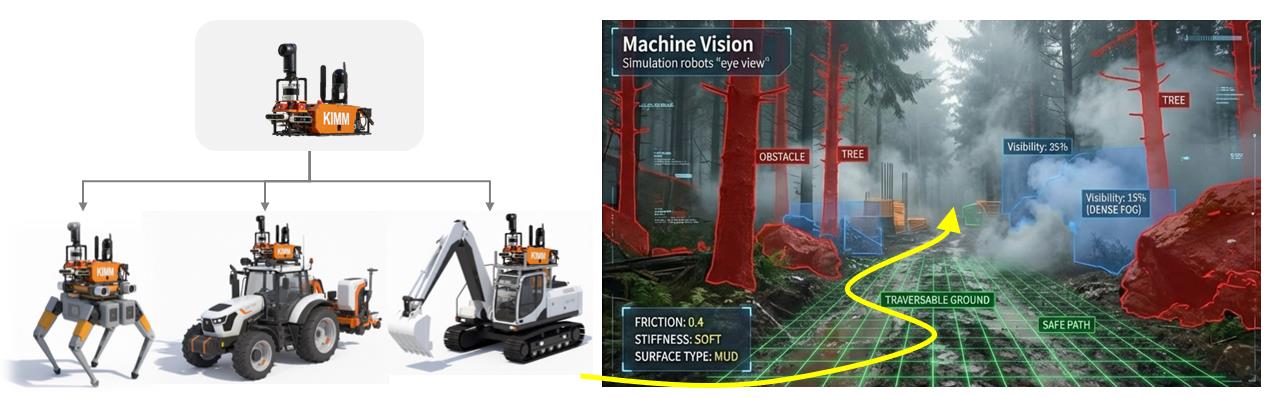
5년차같은 플랫폼 하나로 5종 이상 이기종 필드장비가 레벨 4 자율화
22
18. 2027 전략연구사업 수주
「인구절벽·위험환경 대응 AI 필드로봇 기술 개발」 2027–2031 수주 (5년, 350억)
인구절벽·위험환경 대응
AI 필드로봇 기술 개발
23
19. 성과물
논문 1건 게재 · 기술보고서 1건 완료 · 소프트웨어 등록 1건 신청
논문 게재 완료
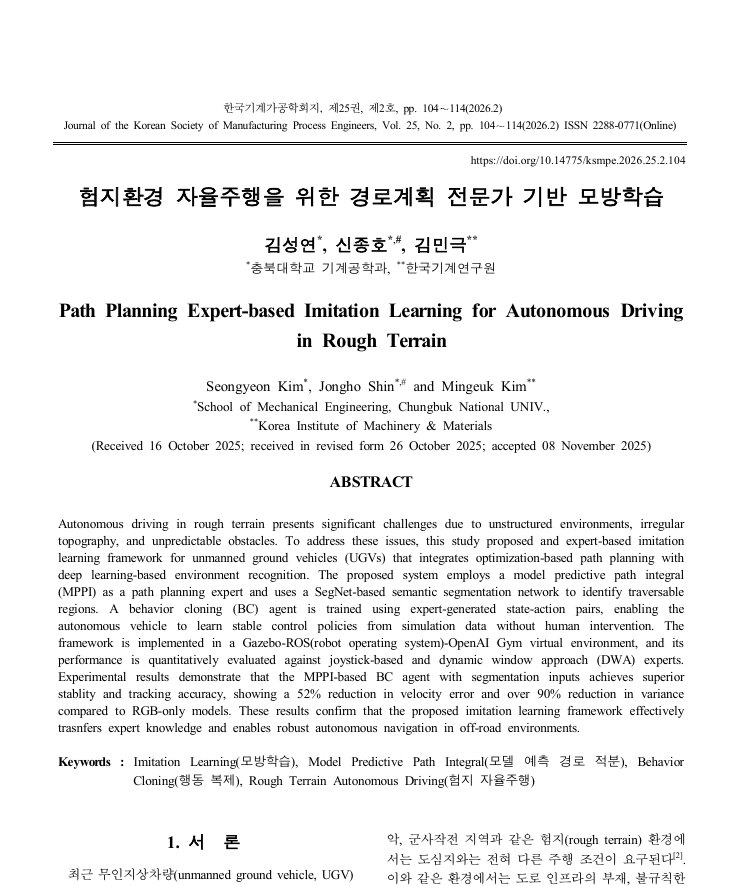
험지환경 자율주행을 위한 경로계획 전문가 기반 모방학습
한국기계가공학회지 제25권 제2호 (2026.2)
기술보고서 완료
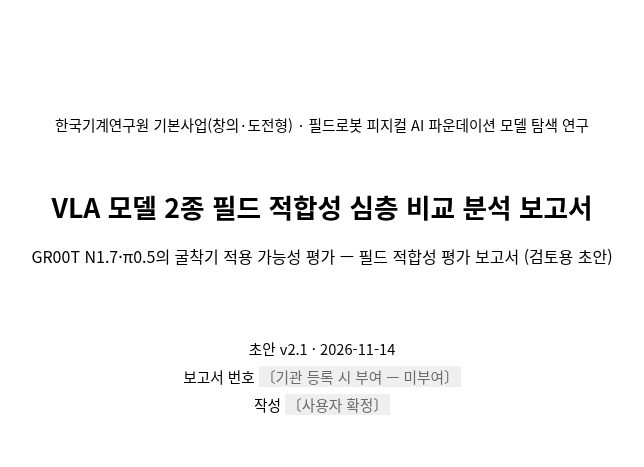
VLA 모델 2종 필드 적합성 심층 비교 분석 보고서
모델 정리 · 학습 방법 · 평가 기준 8가지 · 결과
소프트웨어 등록 신청
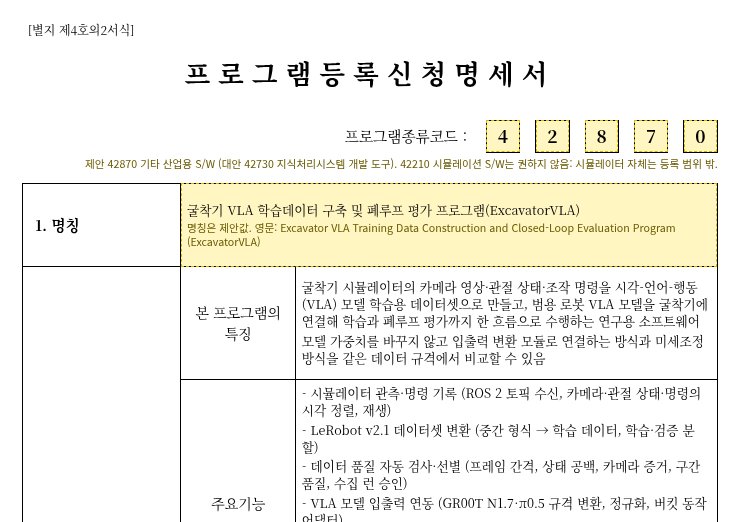
굴착기 VLA 학습데이터 구축 및 폐루프 평가 프로그램
소스 214개 파일 · 약 4.5만 줄
24
20. 요약
계획한 목표 ①~④와 성과물 모두 완료
| 계획서 목표 | 수행 결과 | 상태 |
|---|
| ① VLA 2종 비교 · 필드 적합성 평가 | GR00T N1.7 · π0.5 비교, 직접 실행해 확인 | 완료 |
| ② 굴착 관측–행동 시범 데이터셋 | 시범 수집 → 표준 형식 변환 → 학습 및 검증 | 완료 |
| ③ 모델 적용 실험 · 정량 지표 | 제로샷 확인 · 파인튜닝 후 성능 검증 | 완료 |
| ④ 5년 로드맵 · 2027 전략과제 기획 | 5년 로드맵 작성 · 2027년 전략연구사업 과제 수주 | 완료 |
| 성과물 | 논문 1건 게재 / 기술보고서 1건 완료 / 소프트웨어 등록 1건 신청 | 완료 |
- 로봇파운데이션 모델의 필드로봇 적용 가능성 확인
- 필드 특화 데이터 및 AI 모델 구조 개선 방향 확인
- 전략연구사업 수행을 위한 기반 기술 구축 완료
25
26
부록 · 질의 대비
- A1 계획 대비 변경 사항 · A2 로봇팔 재현과 시범 데이터셋
- A3 버킷 이동 상세 · A4 굴착 첫 평가 · 보완 · 끌기 시점 · 전환 방식
- A5 비VLA 기준선 비교 · A6 지형 지도 입력 방법
- A7 관로 1·2차 교훈 · A8 관로 3차 결과·원인 · A9 관로 4차 실행별·변화
- A10 확인한 적용 조건과 남은 과제 · A11 파인튜닝 방법(GR00T · π0.5) · A12 그림 출처
27
A1. 계획 대비 변경 사항
바뀐 것은 모델 버전 · 시뮬레이터 · 실환경 단계의 시점
| 계획 | 실제 | 사유 |
|---|
| GR00T N1.6 | GR00T N1.7 | 과제 기간에 공개된 최신판 사용 |
| 1단계 Isaac Sim 검증 | APEX 굴착 시뮬레이터(Unity + 변형 지형)에서 수집·학습·평가 | 보유한 굴착 전용 환경을 우선 사용 · Isaac 재현은 미착수 |
| 2단계 테스트베드 실환경 적용 | 미수행 — 시뮬레이터 결과로 적용 조건 정리 | 유압 포함 조건과 실제 장비 검증은 후속 과제 |
| 실환경 자료 포함 데이터셋 | 시뮬레이터 자료 3종 | 위와 같음 |
| 전문가 패널 검토 | 내부 검토로 대체 | 일정 |
| 굴착 영상 | 일부는 표적 공을 숨긴 시연 재촬영 | 수치는 정식 평가 값 |
28
A2-1. 로봇팔 과제 재현
공식 가중치로 같은 과제 10회씩 · 두 모델 모두 10/10
GR00T N1.710 / 10 성공
 왼쪽 전체 카메라 · 오른쪽 손목 카메라 · 실시간 재생
π0.510 / 10 성공
 전체 카메라 · 실시간 재생
“검은 그릇을 집어 접시에 올려라” · 공식 LIBERO 가중치 · RTX 5080 · 추론 중앙값 80~100 ms
29
A2-2. 굴착 시범 데이터셋과 수집 절차
굴착 시뮬레이터에서 영상 · 관절 상태 · 조작 명령을 한 시각축으로 기록
시범 수집 화면 교사 = 규칙 제어기 · VLA 아님
교사(규칙 제어기) 시범 · 꼬깔콘 표적 · VLA 아님 · 왼쪽 운전석 · 오른쪽 붐 카메라 · 2배속자료 3종: 버킷 이동(학습 구간 1,610) · 굴착 네 동작(2,192) · 관로(7,531) · 표준 형식(LeRobot)으로 두 모델이 같은 자료를 사용
30
A3. 버킷 이동 — 처음 보는 위치
어느 자료에도 없던 위치 2곳 · GR00T 4/8 · π0.5 6/8 · 높은 곳은 움직임이 모자람
π0.5 · 낮은 위치 · 콘 성공
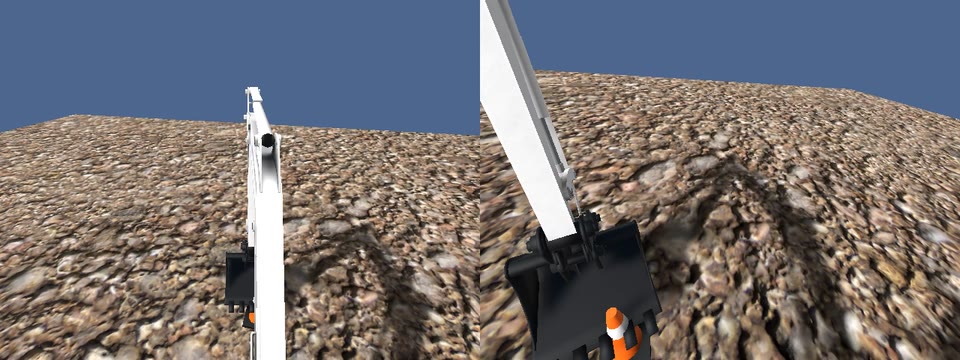
최소 거리0.11 m
π0.5 · 높은 위치 · 콘 실패
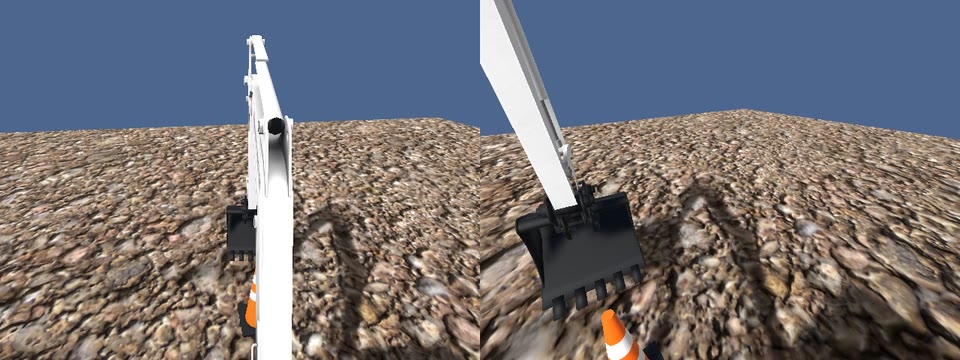
최소 거리0.49 m
꼬깔콘 표적 · 붐 카메라 · 2배속 · 모델 구간만 · 출발 거리 0.92–1.26 m
읽는 법
4/8 · 6/8GR00T · π0.5
- 방향은 처음 보는 위치에서도 대체로 맞음
- 크기가 모자람: 높은 위치에서 붐이 0.12–0.17 rad 낮고 팔이 0.25–0.32 rad 덜 접힘
- GR00T 실패 4건 중 2건은 끝난 뒤 기록 공백 → 거리만 보면 6/8 대 6/8, 우열 미확정
31
A4-1. 굴착 — 첫 평가: 끌기에서 날이 뜸
첫 평가 GR00T 2/4 · π0.5 1/4 · 끌기 네 조건 모두 실패
π0.5 · 끌기 · 검증 위치 실패

날이 흙 위로 뜸 · 흙 속 비율0.22
- 문제 ① 끌기 중간 날 깊이: 교사 +1.6~2.1 cm(흙 속) ↔ 모델 −2.5~−3.8 cm(흙 위)
- 문제 ② 흙을 실은 닫기·올리기에서 화면이 느려져 판정 제외
정식 평가 영상 · 운전석(작은) 화면은 위쪽 일부를 확대 표시
32
A4-2. 굴착 — 첫 실패 뒤 고친 것 세 가지
자료 보강 · 시뮬레이터 동기 정지 · 명령 적용 시점
1끌기 자료 보강새 흙 위치 12곳에서 교사 시연 수집 · 끌기 학습 창 55 → 187 · 끌기 3배 반복해 재학습
왜: 끌기 창이 다른 동작(215–294)보다 훨씬 적었음
오프라인 끌기 붐 오차 1/3–1/4로 감소
실제 끌기는 여전히 실패 → 3번으로
2시뮬레이터 동기 정지모델이 계산하는 0.12–0.2 s 동안 시뮬레이터 시간을 멈추고, 답이 오면 재개
왜: 같은 GPU에서 π0.5 계산 중 화면이 5–8배 느려짐 · 원격 추론은 왕복 0.94 s로 불가
멈춤 218회 모두 정상 · 닫기·올리기도 판정 가능해짐
3명령 적용 일정 맞추기왜: 학습 자료의 명령은 관측 0.07 s 뒤 것인데 시험 프로그램은 요청 0.2 s 뒤부터 적용 → 0번 칸이 늦어 붐을 더 올림 · 계산 중엔 시뮬레이터를 멈추므로 계산 시간 탓 아님
재학습 없이 끌기 8/8
33
A4-3. 굴착 — 끌기: 명령 적용 시점 보정
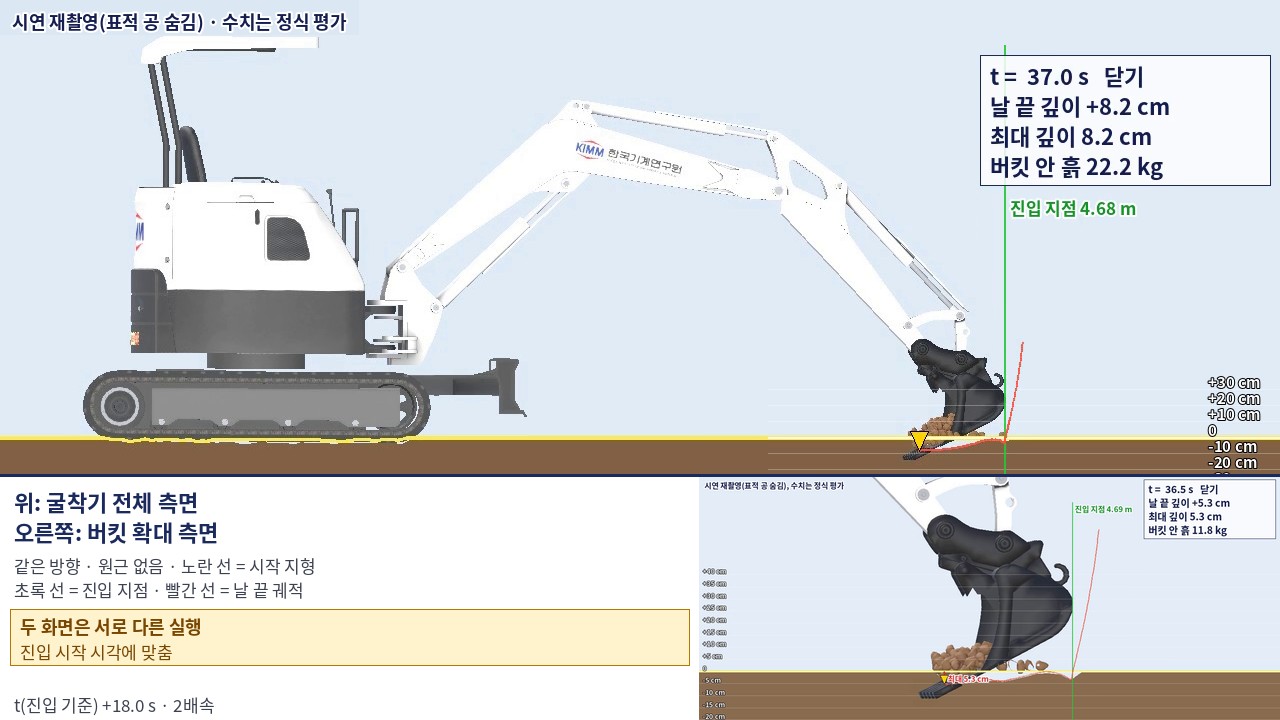
원인은 모델이 아니라 명령 적용 시점 · 재학습 없이 8/8
GR00T · 학습 위치
π0.5 · 검증 위치
보정 전11/11
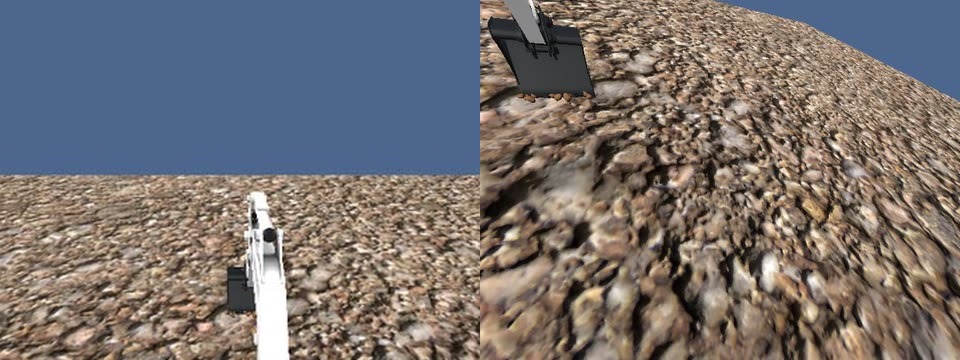
흙 속 0.33 · 0.68 kg실패

흙 속 0.75 · 1.75 kg실패
둘째 칸부터 실행
8/8끌기 성공
- 학습 자료 명령 = 관측 0.07 s 뒤 · 시험 적용 = 0.2 s 간격 일정 → 첫 칸이 늦음
- 두 모델 × 두 위치 × 실행 칸 수 2가지 · 흙 속 비율 1.0
- 재학습 없음 · 계산 중 시뮬레이터 정지라 계산 시간 탓 아님
보정 후11/12
흙 속 1.0 · 3.83 kg성공
흙 속 1.0 · 5.50 kg성공
붐 카메라 · 작은 화면 = 운전석 화면(보정 전 줄은 위쪽 일부 확대) · 0.5배속 · 끌기 모델 구간만 · 앞 동작은 교사(VLA 아님) · 이 실행 방식은 끌기 실패를 본 뒤 고름
보정 후 줄: 시연 재촬영(표적 공 숨김), 수치는 정식 평가 · 보정 전 줄: 정식 평가 영상 · 운전석(작은) 화면은 위쪽 일부를 확대 표시
34
A4-4. 굴착 — 바깥 전환과 스스로 전환
지시문 4개 + 바깥 넘김 신호 ↔ 지시문 하나, 넘길 때를 모델이 판단
- 바깥 전환: 두 모델 × 두 위치 모두 네 동작 통과
- 스스로 전환: 검증 위치 두 모델 완주 · 학습 위치는 관입 깊이 미달
- 반복: GR00T 3번 중 2번 · π0.5 3번 중 1번 완주
- 흙 30 kg 이상 구간은 화면이 느려 전체 시연 성공으로는 세지 않음
35
A5. VLA 대 비VLA 기준선
작은 모방학습 모델(ACT)도 대체로 비슷 · 우열은 일반화하지 않음
| 시험 | GR00T | π0.5 | ACT (비VLA) |
|---|
버킷 · 검증 위치
공·콘 3위치 | 6/6 | 6/6 | 6/6 |
버킷 · 시험 위치
출발이 표적 근처 → 변별력 낮음 | 7/8 | 7/8 | 6/8 |
버킷 · 처음 보는 위치
ACT는 낮은 위치 4번 중 3번 실패 | 4/8 | 6/8 | 3/8 |
굴착 · 동작별 통과
ACT 관입 두 위치 실패 · 끌기는 둘째 칸 방식 | 4/4 | 4/4 | 3/4 |
연속 굴착 · 동작 판정
학습 위치 · 검증 위치 | 4/4 · 4/4 | 4/4 · 4/4 | 4/4 · 4/4 |
연속 굴착 · 화면 기준까지 성공
성공 동작 수 · 나머지는 판정 제외(검증 불가) | 2 · 1 | 1 · 2 | 4 · 3 |
연속 굴착 · 최대 흙
흙이 적으면 시뮬레이터가 덜 느려짐 | 32 · 33 kg | 42 · 48 kg | 20 · 13 kg |
모델 응답 시간(중앙)
같은 GPU | 103–109 ms | 119–122 ms | 14 ms |
읽을 때 주의
- ACT = 카메라 2대·관절 상태만 보고 명령 묶음을 내는 작은 모방학습 모델 · VLA 아님
- 모델·위치·방식당 run 1개 → 우열을 일반화하지 않음
- ACT 연속 굴착 ‘네 동작 성공’은 흙이 VLA의 절반 이하라 시뮬레이터가 덜 느려진 것 · VLA의 ‘판정 제외’는 실패가 아니라 검증 불가
- ACT는 응답이 7–9배 빨라 시뮬레이터 멈춤도 짧음
36
A6. 지형 지도를 모델에 넣는 방법
굴착 지점을 알려 줄 때는 제외 · 스스로 위치를 정할 때 필수
37
A7. 관로 1·2차 — 지도 보고 팔 곳 고르기
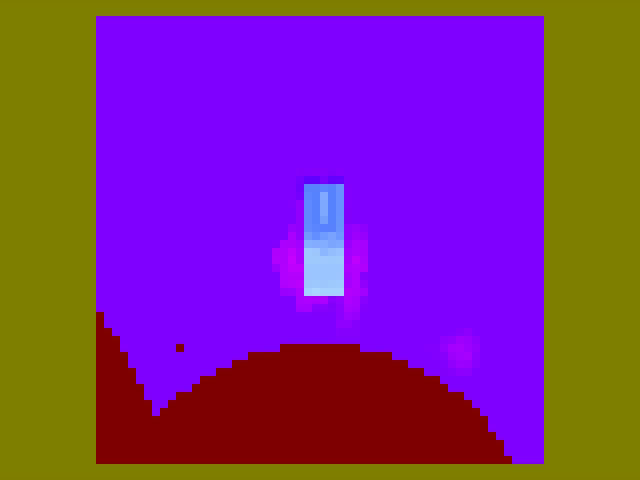
두 번 학습 모두 확인 못 함 · 들어간 곳은 늘 4.0–4.2 m
모델 입력 지도 · 1판 (넓게)
모델 입력 지도 · 2판 (관로 확대)
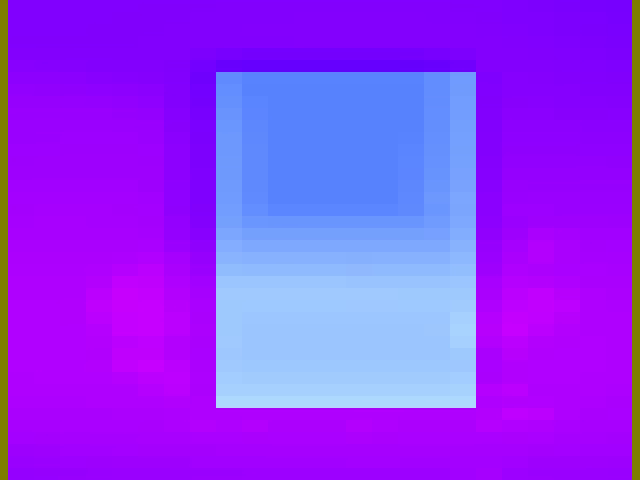
같은 지형 B · 가운데 띠 = 관로 · 밝을수록 덜 판 곳 · 팔 곳 표식은 넣지 않음(모델이 스스로 고르는지 시험)
① 장면만 봐도 답이 정해짐
1차 자료는 지형 모습과 팔 곳이 한 쌍씩 묶임(값 5개) → GR00T는 본 지도만 외우고, π0.5는 지도 대신 카메라로 정함
② 지도를 키워도 연결이 안 생김
2차: 관로 확대 지도 + 같은 장면에 팔 곳만 다른 시연 추가(값 9개) → 지도만 바꿔 넣으면 진입 위치 이동 최대 4 cm
③ 추가 시연의 결함
새 시연 16번 중 12번은 교사 버킷이 흙에 닿지 않음 → 2차 모델은 4번 모두 흙에 들어가지 않음
다음 과제
팔 곳을 규칙이 계산해 숫자·표식으로 알려 주기 · 흙을 실제로 파는 시연으로 다시 수집 · 조건마다 반복 수 늘리기
38
A8. 관로 3차 — 교사를 고쳐 다시 학습
정해 둔 기준을 채운 모델은 없음 · 32번 중 4번은 실제로 흙을 파냄
GR00T · 통과한 실행 성공
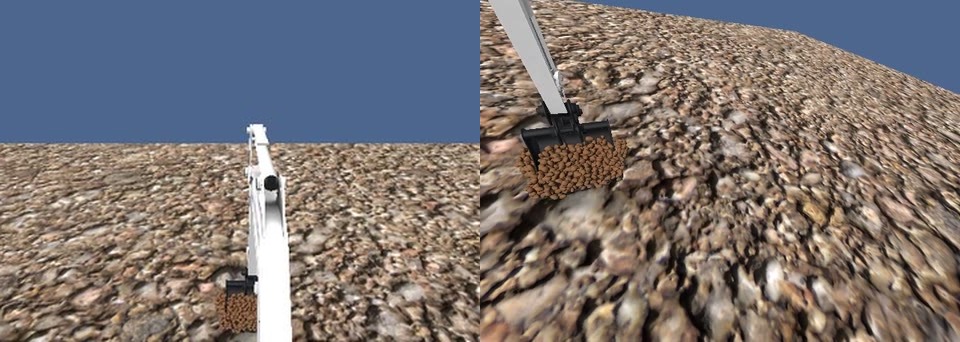
버킷에 담긴 흙36 kg
바꾼 것: 교사가 매번 흙을 파도록 수정 → 시범 60번 다시 수집 → 모델 8개(두 모델 × 표식 유무 × 시범 전체·절반) · 전체·절반 차이의 이유는 가르지 못함(학습 한 번씩)
정식 평가 영상 · 운전석(작은) 화면은 위쪽 일부를 확대 표시
39
A8-2. 관로 3차 — 실패 원인
진입 실패 22번 중 21번: 충분히 들어가기 전에 당기기 시작 · 시범의 여유 0.4–0.5초
GR00T · 실패한 실행 실패
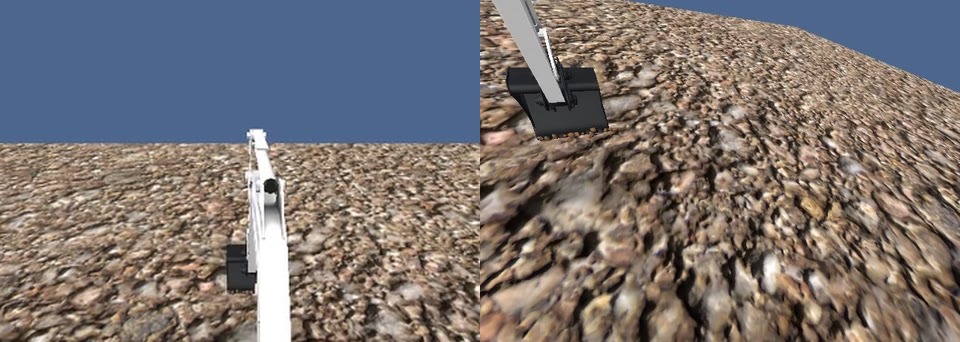
날이 표면에 닿자 당김빈 버킷
정식 평가 영상 · 운전석(작은) 화면은 위쪽 일부를 확대 표시
40
A9. 관로 4차 — 실행별 결과와 남은 과제
통과 4/12 · 한 모델이 두 지형 모두 통과한 경우는 없음
바꾼 것
교사가 목표 자세에 닿은 뒤 2.0초 머물고 당김(종전 0.5초) · 교사 진입 깊이 중앙 5.8 cm(3차 4.3) · 시범 28번 다시 수집
사후 보충 평가(끌기 한도 +2초, 4번 · 별도 집계)
통과 0/4 · GR00T 가까운 곳: 끌기·닫기 완료, 버킷 67 kg이나 너무 깊이 팜(최대 5.8 cm)·올리기 미완 · 먼 곳: 확인 불가 · π0.5: 흙을 못 담음 → 시간 한도는 주원인 아님
남은 과제 — 굴착 깊이 제어 · 흙 담기 · 올리기
GR00T가 목표 바닥보다 깊이 판 경우 3/12(2번 기준 초과, 최대 4.8 · 9.8 cm) · 교사는 0 · 원인 미분석
π0.5
진입 깊이는 4번 모두 충족 · 굴착량이 기준에 못 미침
41
A9-2. 관로 3차 → 4차 변화
시범을 고치자 이른 당기기 22/32 → 1/12 · 통과 4/12, 성공 기준은 미충족
남은 과제: GR00T 굴착 깊이 제어(너무 깊이 판 경우 3/12) · π0.5 흙 담기 · 올리기 완료
보충 평가 0/4 끌기 시간 한도를 2초 늘린 사후 평가 4번(별도 집계)도 통과 없음 — 시간 한도는 주원인 아님
42
A10. 확인한 적용 조건과 남은 과제
맞춰야 할 것은 입출력 · 시범 · 명령 시점 · 남은 것은 굴착 깊이 제어 · 흙 담기 · 실제 장비
입출력 정의
로봇팔용 손끝 행동은 그대로 안 통함 → 4관절 속도 명령으로 다시 정의하고 학습
시범 설계
빠진 출발 자세, 흙에 닿지 않는 시범, 짧은 전환 여유가 그대로 실패로 나타남 → 시범 품질이 성능을 좌우
명령 시점
학습 자료와 실행 프로그램의 시점이 어긋나면 동작 실패 → 맞추면 재학습 없이 해결
비교 기준
언어를 읽지 않는 작은 모방학습 모델도 같은 자료에서 대체로 비슷 → VLA의 우위는 아직 미확인
시뮬레이터 범위
유압 제외 · 추론 중 시간 정지 · 조건당 1–4회 실행 → 실제 장비 성능은 다음 단계
남은 과제 — 굴착 지점을 스스로
관로 4차: 진입은 해결 · GR00T 굴착 깊이 제어, π0.5 흙 담기, 올리기 완료가 남음
43
A11-1. 파인튜닝 방법 — GR00T N1.7
시각·언어 모델은 고정, 로봇별 투영층과 확산 헤드를 학습
44
A11-2. 파인튜닝 방법 — π0.5
두 큰 블록은 LoRA, 영상 인코더와 입출력 투영은 전체 학습
45
A12. 그림 출처
본문 그림 가운데 외부 자료의 출처
| 쓴 곳 | 출처 |
|---|
| 서론 ② 기술 동향 | 그림: Physical Intelligence (π0.5 논문, arXiv:2504.16054) · NVIDIA Newsroom · FieldAI · 한국기계연구원 |
| 서론 ③ 연구 필요성 | RT-X · 공개 자료 규모 · 왼쪽 그림: Open X-Embodiment Collaboration, arXiv:2310.08864 (CC BY 4.0, 일부를 잘라 씀) |
| 굴착 지점 ① 공략점 도식 | Jud 외 (2017), IEEE Robotics and Automation Letters 의 공략점 선택 방식을 본떠 그림 |
46