굴착기 VLA 진행 보고 — NST필드로봇 탐색연구 · 진행 보고굴착기 VLA 적용
기존 모델 분석 → 파인튜닝 → 버킷 이동·굴착 결과
2026.11.15 · 완료된 결과까지
이한민 01
1. 전체 흐름
학습 전 0/72 → 학습 후 시뮬레이터에서 버킷 이동·굴착 네 동작 수행
01모델 이해GR00T N1.7 · π0.5
구조와 입출력
02로봇팔 검증MuJoCo 픽앤플레이스
두 모델 10/10
03굴착기 무학습버킷을 공까지
72회 모두 실패
04버킷 이동 학습검증 위치 6/6
새 위치 4/8 · 6/8
05굴착 학습동작별 3/4
끌기 8/8
연속 굴착 두 모델 2/2
06팔 곳 고르기지도 입력 · 세 번 학습
기준 통과 없음
3차 32번 중 4번 굴착
02
발표자 메모 · 근거
흐름: 모델 이해(구조·입출력) → LIBERO 로봇팔 검증 → HR35 MuJoCo 무학습 시도 → 파인튜닝 계획(방법·APEX 데이터·3단계) → 버킷 이동 학습 결과 → 굴착 학습 결과 → 비VLA 기준선 → 관로(지도 보고 팔 곳 고르기) → 계획 대비 진행 → 진행 중 과제. 2026-11-15 기준 완료된 결과만 싣는다(관로 4차는 진행 중이라 싣지 않음).
06 근거: docs/execution/models/trench-results-summary-2026-11-14.md(1·2차: 접근 13회 모두 완료, 진입 위치는 팔 곳과 무관하게 4.0–4.2 m, 지도 교체 시험 기준 미달. 3차(§8): 사전 등록 기준 통과 구성 0, 실행 통과 32회 중 4회, 진입 실패 22회 중 21회가 깊이 확보 전 끌기 시작).
학습 후 수치 근거: docs/execution/results/2026-11-12-numbers.md §1(버킷)·§2(굴착).
수치 근거: LIBERO 10/10 ×2 = (실행 기록) · 굴착기 72회 0성공 = docs/research/2026-11-07-vla-excavator-zero-shot-independent-analysis.md §4.
2. GR00T N1.7 — 모델 구성
보고 읽는 시각·언어 모델 + 동작을 그리는 확산 액션 헤드
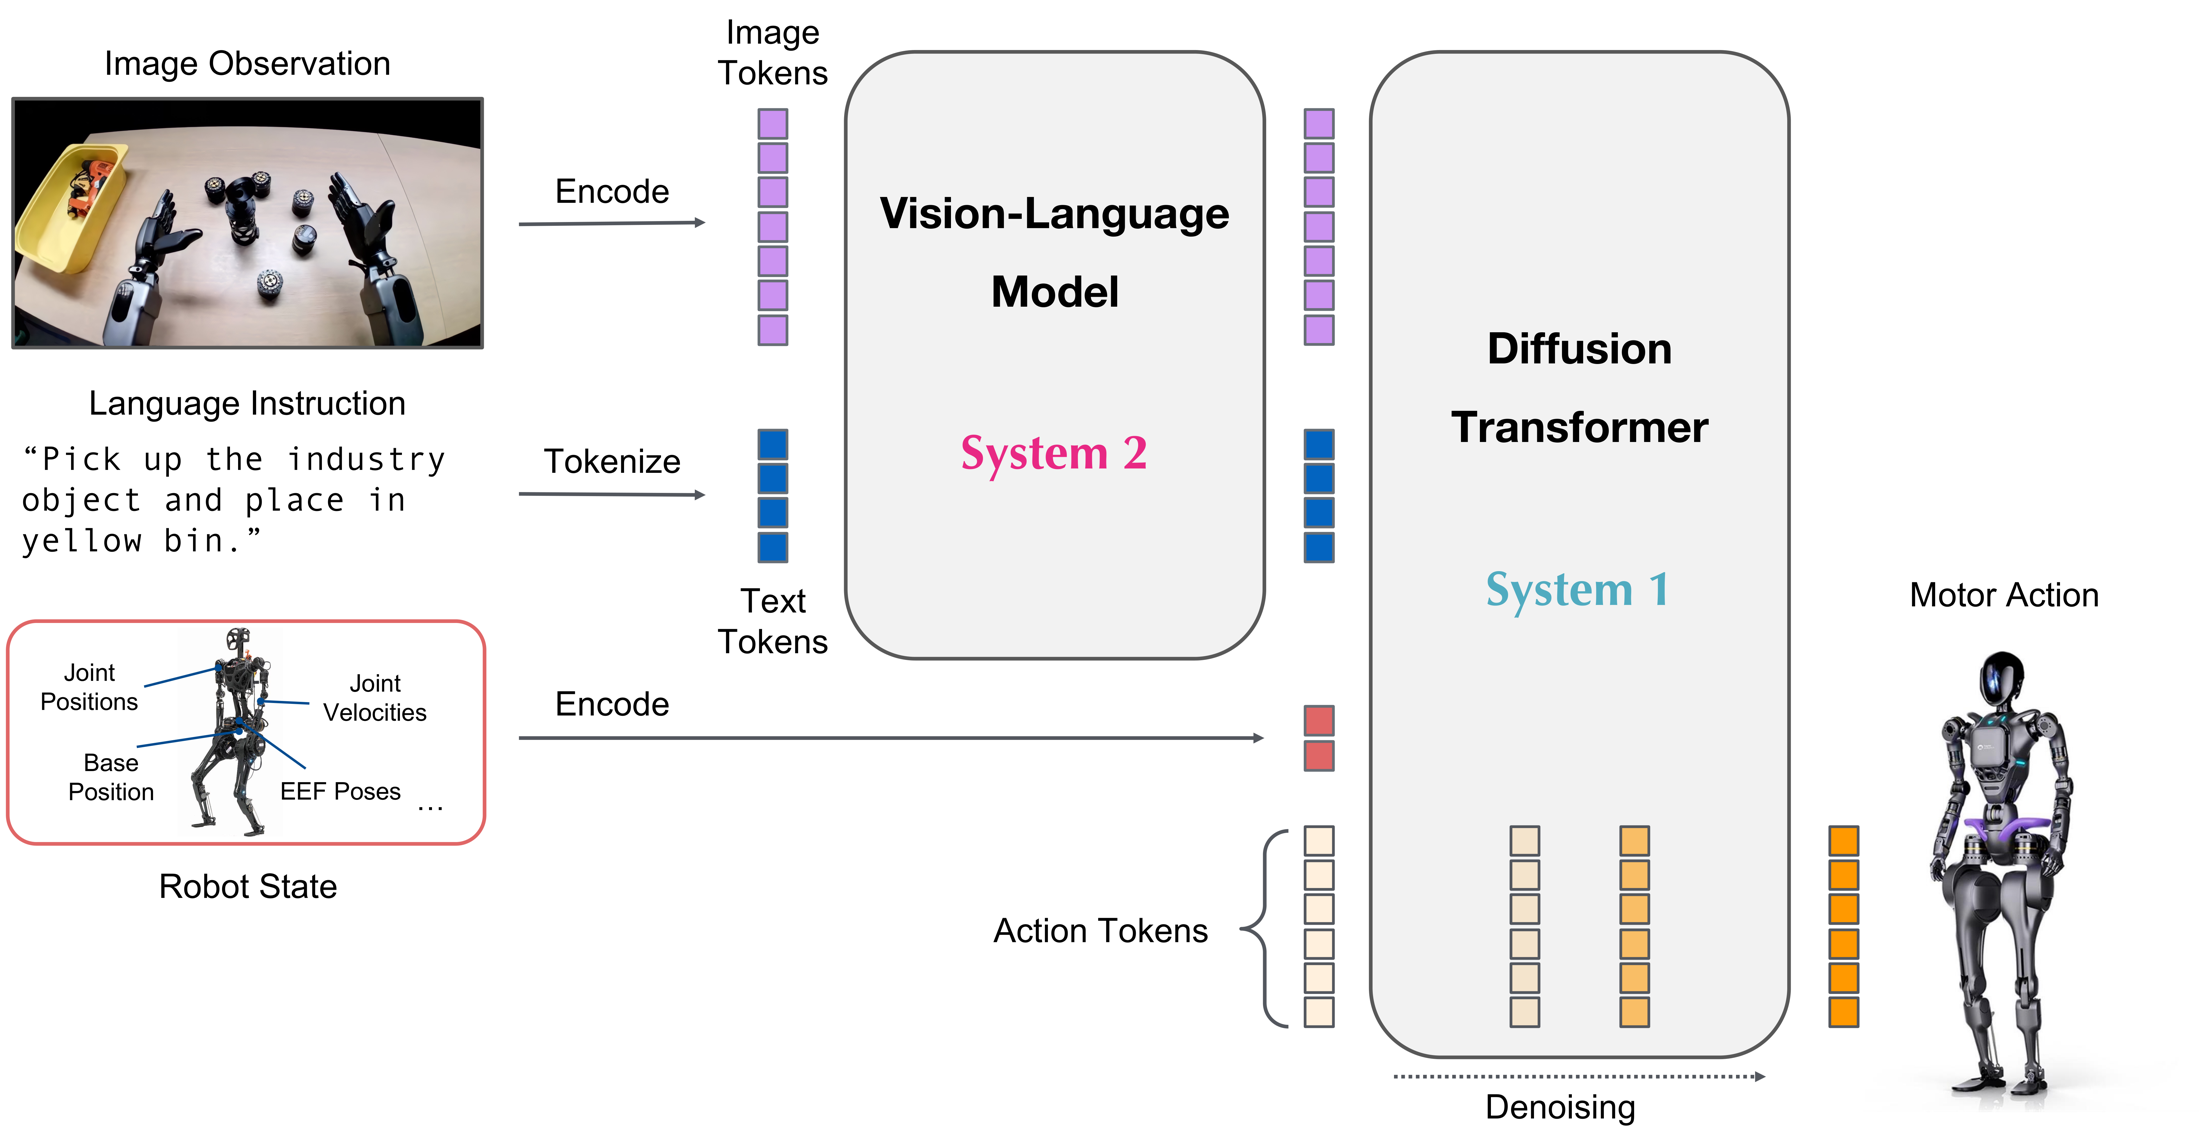
시각·언어 모델 · 2BCosmos-Reason2 · 영상·지시문을 특징으로
확산 액션 헤드 (DiT)잡음에서 행동 묶음을 4단계로 다듬음
로봇별 투영층상태 인코더·행동 디코더 32슬롯 · 로봇마다 교체
그림: NVIDIA Isaac-GR00T 공식 저장소 (Apache-2.0) · github.com/NVIDIA/Isaac-GR00T media/model-architecture.png (N1 계열 공통 그림, N1.7 모델 카드에도 동일 게재)
03
발표자 메모 · 근거
총 3B. 백본 nvidia/Cosmos-Reason2-2B(게이트), 공개 체크포인트 nvidia/GR00T-N1.7-3B. 상태·행동은 키별 1~99 백분위 → [−1,1] 정규화 후 132차원까지 0 패딩. embodiment 태그 → 투영 슬롯(LIBERO 2, new_embodiment 10).
근거: docs/research/2026-11-04-model-io-contract.md §2 (Isaac-GR00T c56f541 코드 읽기). 그림 출처는 하단 표기.
3. π0.5 — 모델 구성
시각·언어 모델 3B가 영상·글을 읽고, 액션 전문가 0.3B가 잡음에서 행동 묶음을 만든다
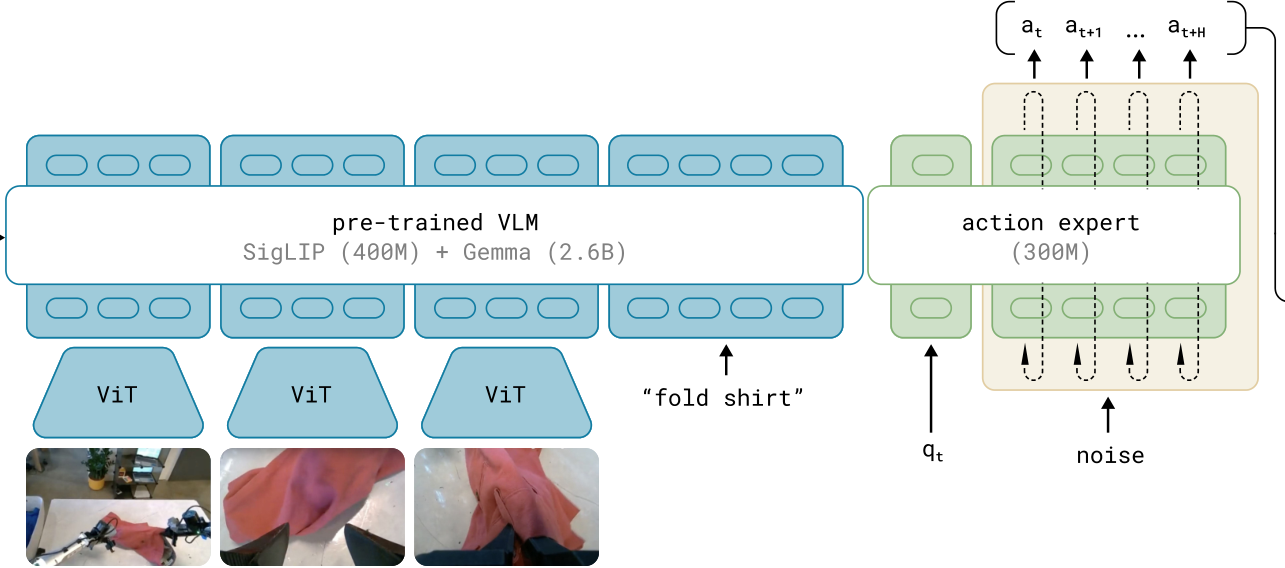 π0 논문 그림 3의 모델 부분 · π0.5도 같은 뼈대, 차이는 상태 qt를 숫자 토큰으로 바꿔 시각·언어 모델 쪽에 넣는 것(π0는 액션 전문가 쪽)과 이산 토큰 사전학습 → 플로우 매칭 후학습의 두 단계
시각·언어 모델 · 3BSigLIP 영상 인코더 + Gemma 언어 모델 · 영상 3장 224 + 지시문 (+ π0.5: 상태 토큰)
액션 전문가 · 0.3B잡음에서 시작해 플로우 매칭 10단계로 행동 묶음 at…at+H
상태 qt의 자리π0: 선형층 → 액션 전문가 · π0.5: 256구간 숫자 → 텍스트 토큰 → 언어 모델
그림: Physical Intelligence, π0 논문(arXiv 2410.24164) Fig. 3 모델 부분 잘라냄 · π0.5 논문(arXiv 2504.16054) §IV-A·부록 A-E가 상태 토큰화 근거 · © Physical Intelligence
04
발표자 메모 · 근거
그림은 π0 논문 Fig. 3(overview.png)에서 데이터 혼합·로봇 패널을 빼고 모델 부분만 잘라냈다. π0.5 논문 Fig. 3(assets/arch-pi05.png, 두 단계 학습 개요)은 상태 입력을 그리지 않아 보조로만 둔다.
상태 경로: π0는 q_t를 선형층(state_proj)으로 액션 전문가 토큰열에 넣는다(openpi pi0.py L97, L151–157). π0.5는 상태를 256구간으로 이산화해 "Task: …, State: 12 87 …;" 식 텍스트로 만들어 PaliGemma 언어 모델이 읽는다(pi0_config.py L28–41, tokenizer.py L24–28; 논문 §IV-A "The robot proprioceptive state is discretized and input to the model as text tokens", 부록 A-E, Fig. 18 어텐션 마스크의 State 블록). 공식 pi05_libero 설정은 pi05=True이면서 discrete_state_input=False라 상태를 전혀 받지 않는다(config.py L744–745).
행동 쪽: 잡음 행동 → action_in_proj(선형) → 액션 전문가 → action_out_proj(선형) → 32칸 행동. 시간 단계는 π0.5에서 time_mlp → adaRMSNorm으로 주입. 영상 3슬롯 224×224, 정규화 (x−q01)/(q99−q01)·2−1 클리핑 없음, action_horizon 10(LIBERO)/50(base).
근거: docs/research/2026-11-04-model-io-contract.md §3, openpi 215abfb.
4. 두 모델의 입력과 출력
입력은 영상 + 지시문 (+ 상태) · 출력은 시간 × 7차원 행동 묶음
05
발표자 메모 · 근거
영상 예시는 LIBERO-Spatial 과제 0의 실제 모델 입력 프레임(GR00T 영상에서 잘라냄). 행동 7D = 말단 위치 Δxyz 3 + 회전 3 + 그리퍼 1(LIBERO). GR00T: 16스텝 예측·8스텝 실행, 상태 8D를 투영층으로. π0.5: 10스텝 예측·5스텝 실행, 공식 LIBERO 가중치는 상태 미사용.
근거: docs/research/2026-11-04-model-io-contract.md §2·§3, examples/LIBERO/README.md(두 저장소).
5. 로봇팔 검증 — 픽앤플레이스
같은 과제 10회씩, 두 모델 모두 10/10 · 환경은 MuJoCo
GR00T N1.710 / 10 성공
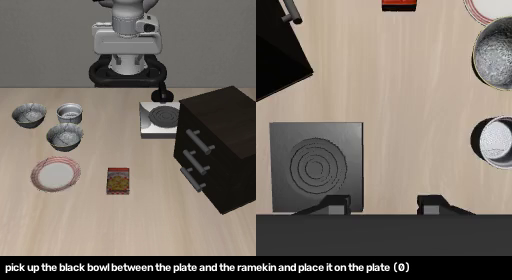 왼쪽 전체 카메라 · 오른쪽 손목 카메라 · 실시간 재생
π0.510 / 10 성공
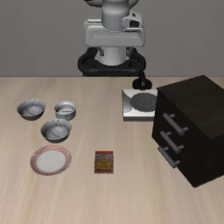 전체 카메라 · 실시간 재생
“검은 그릇을 집어 접시에 올려라” · 공식 LIBERO 가중치 · RTX 5080 · 추론 중앙값 80~100 ms
06
발표자 메모 · 근거
LIBERO-Spatial task0 "pick up the black bowl between the plate and the ramekin and place it on the plate". 2026-11-05, RTX 5080(sm_120, 드라이버 595.91.07), bf16.
π0.5: pi05_libero(gs://openpi-assets), openpi 215abfb, seed 7, replan 5, 220스텝 상한, 10/10, p50 97 ms/p95 110 ms, VRAM 최대 11.1 GB. 로그 (실행 기록)
GR00T: GR00T-N1.7-LIBERO/libero_spatial(rev ), Isaac-GR00T c56f541, seed 7, 8스텝 실행, flash_attention_2, 10/10, p50 80.2 ms/p95 104.9 ms. 로그 (실행 기록)
주의: 두 실행의 초기 상태 설정이 달라 같은 초기조건 비교는 아님. 제로샷이 아니라 LIBERO로 미세조정된 공식 가중치. GR00T 영상은 원본 20 fps를 10 fps로 늦춰 실시간에 맞춤.
6. 굴착기에 그대로 연결하기
로봇팔 손끝 이동량을 버킷 끝 이동량으로 읽고 4관절로 푼다
07
발표자 메모 · 근거
MuJoCo 3.3.1, APEX HR35 URDF 변환 모델, 고정 차체, 중력 0, 충돌 끔, 위치 서보 kp100/kv20. 전체 카메라 (6,7,4)→(0,1,1.2) fovy 45°, 붐 카메라 fovy 85°, 640×480. 지시문 "move the bucket toward the orange ball". 7D 출력 중 Δxyz만 ×0.05 m → 축 대응 M → 3×3 국소 역기구학(버킷 피치 유지) → 스윙·붐·암·버킷 절대 목표각, 0.1 s 간격, 50스텝(5 s). 상태: GR00T 버킷 끝 위치·자세 + 가상 그리퍼 2 = 8D, π0.5 미사용.
근거: docs/research/2026-11-07-vla-excavator-zero-shot-independent-analysis.md §3, scripts/simulation/hr35_mujoco/README.md, docs/execution/models/bucket-move-pretrain.md.
7. 연결 자체는 동작한다 — 목표를 아는 제어기
공 위치를 아는 기구학 제어기는 0.95 → 0.01 m 도달 · 모델 없음
전체 카메라
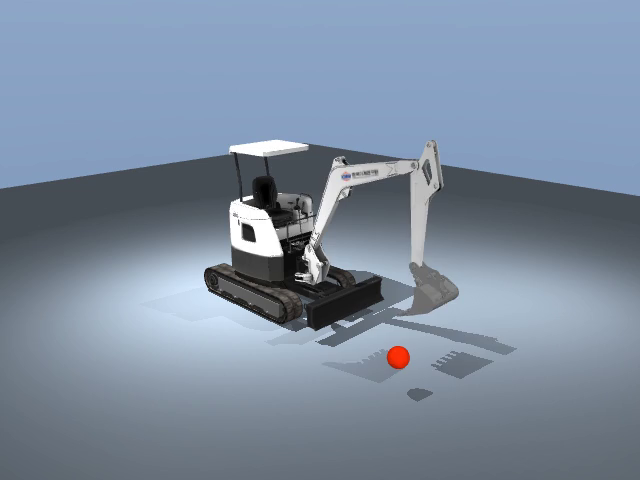 같은 역기구학·같은 서보로 버킷 끝이 공까지
붐 카메라
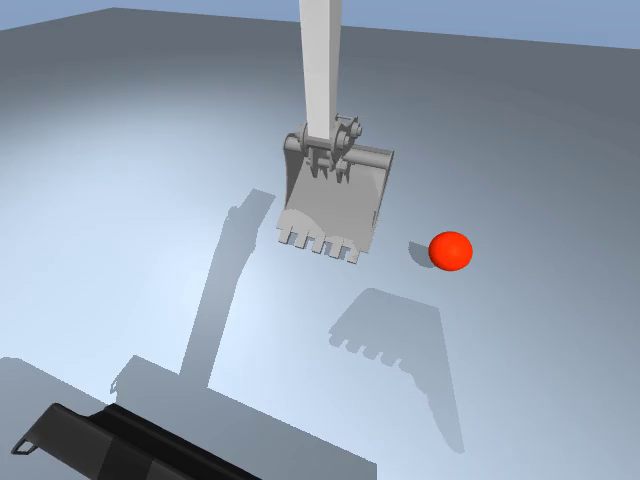 23스텝에 0.5 m 안 · 48스텝에 0.011 m · 모델 없음
이 영상은 VLA 결과가 아니다 · “모델이 방향만 맞게 내면 도달 가능”을 보인 기준선
08
발표자 메모 · 근거
오라클(야코비안) 제어기: 목표 좌표를 직접 받아 같은 IK·서보 경로로 구동. target1 0.952 → 0.011 m(23스텝), target2 0.959 → 0.014 m. 영상 (실행 기록) 근거 docs/execution/media/hr35-mujoco-oracle01.md.
의미: 연결층·시뮬레이터·명령 경로는 정상. 실패 원인은 모델 출력 쪽에 있다.
8. 학습 없이 여러 방법을 바꿔 봤지만
72회 시도(표적 보임 54 · 숨김 대조 18) · 0.5 m 안 도달 0회 · 최근접 0.58 m
09
발표자 메모 · 근거
붐 카메라 시점(두 시점 영상 중 오른쪽을 잘라냄), 시작 거리 약 0.95 m, 성공 기준 버킷 끝~공 0.5 m. 표시 수치는 해당 에피소드 최종 거리(모두 표적 1).
GR00T 줄: 실제 자세 상태 0.916 m(gpu01/physical_world-target01) · 명령 누적 기준 1.015 m(reference-manual-ssd-runfirst05/target01, 최소 0.919) · 카메라 확대 1.047 m(fovy34-manual-ssd-runfirst01/target01, 최소 0.918) · 이동량 2배 0.942 m(gain2-manual-ssd-runfirst01/target01, 최소 0.917).
π0.5 줄 아래 설명 참고.
π0.5 첫 시도 0.896 m((실행 기록)) · GR00T 실제 자세 상태 0.916 m(hr35_gr00t/gpu01/physical_world-target01) · GR00T 명령 누적 기준 target2 0.864 m(reference-manual-ssd-runfirst05) · π0.5 거울 축 D1/ep0 0.792 m(mirror_v1_attempt9) · π0.5 확대 D1/ep0 0.767 m(r1_fovy) · π0.5 이동량 2배 D1/ep0 0.583 m(gain2). 이 밖에 숨긴 공 대조, 명령 유지 0.2 s, 5스텝 실행, 서보 이득↑ 등도 모두 실패.
집계: 폐루프 72회(보이는 목표 54 + 숨김 대조 18), π 58 / GR 14, 0.5 m 도달 0. 근거 docs/research/2026-11-07-vla-excavator-zero-shot-independent-analysis.md §4·L151–158, (실행 기록)
9. 중간 결론
파인튜닝 없이 다른 장비에 그대로 쓰는 것은 불가능(이번 시험 범위의 결론) → 데이터와 학습으로
10
발표자 메모 · 근거
그림: 시도별 최종 거리를 0.5 m 기준선과 함께 표시(presentations/vla-experiment-story/build_figures.py 생성본 재사용). 세 가지 원인(독립 분석): ① π 이동량 부족(27회 최대 0.333 m, 필요 0.452 m) ② 두 모델 모두 공 좌우 위치 무시(GR은 매번 약 (−0.13, 0.99, 0.05) 방향) ③ 암 관절이 하한에서 시작해 거부 220건이 모두 암 축. 사용자 합의: 무학습 조정 중단, 파인튜닝으로 전환().
10. 기존 사례 ① Actor Labs — 실제 굴착기에 π0.5
운전자 손을 카메라로 보고 라벨을 만들고, 조이스틱 4축을 행동으로 π0.5를 LoRA 학습
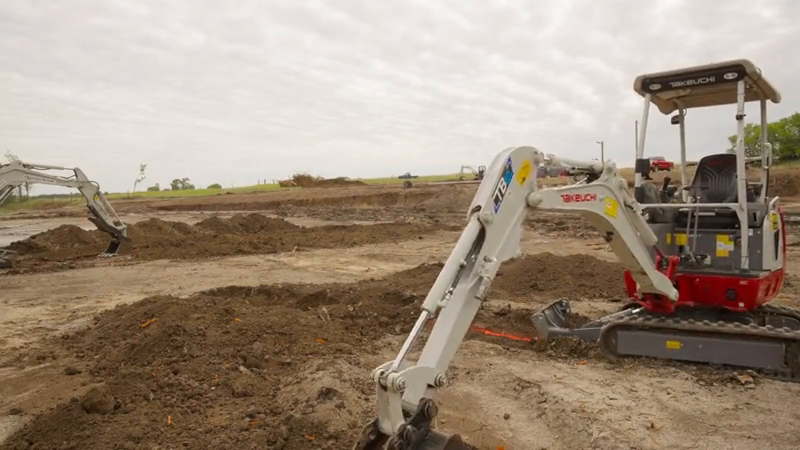 위: 실제 현장에서 두 번 떠서 붓는 자율 작업(2026-05) · 아래: 여러 현장·조명의 성공 모음, 운전석에 단 제어 상자
- 데이터
- 운전자가 조이스틱을 조작하는 모습을 운전석 카메라로 촬영하고, YOLO로 스틱 위치를 읽어 행동 라벨(조이스틱 4축 값)을 만듦 · 기계 개조 없는 카메라 키트(15분 설치) · 실내 200 궤적 → 현장 숙련자 2.5시간 · 자체 VR 원격조작 병행
- 입·출력
- 카메라 3대(120°, 720p) + 지시문 (+ 현재 조이스틱 값) → 다음 시점의 조이스틱 위치 4개 [좌x 좌y 우x 우y], 10 Hz · 관절 각도는 쓰지 않음(엔코더 없음) · 분위수 정규화
- 모델·학습
- π0.5 + LoRA 파인튜닝(openpi) · 플로우 매칭 행동 묶음 · 기체 Takeuchi TB20e 전동 미니 굴착기(렌탈) · 추론 Jetson Thor 또는 Starlink 원격, 명령은 CAN 버스
- 결과
- 실제 현장에서 참호 굴착·선회·덤프 자율 수행 영상(실시간) · 맑음·흐림·새벽·야간, 다른 현장에서도 동작했다고 주장 · 60대 이상 기계로 수집 확대
- 한계
- 성공률·사이클 시간·실패 사례 수치 없음(회사 블로그, 성공 장면 모음만) · 힘·부하 피드백 없이 영상만 · 2.5시간이 전체인지 마지막 적응분인지 불명
출처: labs.actor/research/vla-excavator (2026-03-07) · labs.actor/research/excavator-in-the-wild (2026-05-25) · 영상·그림 © Actor Labs
11
발표자 메모 · 근거
Actor Labs(미국 스타트업) 기술 블로그 2편. 1편(2026-03-07, L. Burgett, S. S. Verma 외): 세 장벽(데이터·인터페이스·모델). 데이터: Actor Collector Node — 기계에 계측을 달지 않고 캡 안 카메라로 운전자의 조이스틱 조작을 YOLOv8로 관측해 4D 행동 라벨 생성, 미 전역 다수 기계 배포(Castro Valley CA·Hill City KS 참호 굴착 등), 자체 VR 원격조작·가시선 조작 데이터 병행. 인터페이스: Jetson Thor + CANBUS. 모델: π0.5 LoRA, 다음 조이스틱 상태 직접 예측(영점 문제 우회), 분위수 정규화, 데드존 0.12. 2편(2026-05-25): 숙련 운전자 2.5시간 관찰 → 실제 현장 토공 자율 수행, 조명·장소 적응, 60대 이상 기계 협업, 영상 2개(success-grid, two-scoops)만 게시. 정량 지표·베이스라인·실패 사례 없음.
우리 시사점: 행동 공간을 조이스틱(=우리의 정규화 레버 명령 [−1,1] 4축)으로 둔 점이 APEX 명령 규격과 같다. 사전학습 모델 + 소량 현장 데이터로 동작했다는 주장은 우리의 파인튜닝 경로를 지지하지만 수치가 없어 기대치 산정에는 못 쓴다.
근거: 볼트 02_research/필드로봇/2026 Actor Labs - A VLA Policy for an Excavator_요약.md, 2026 Actor Labs - Excavator in the Wild_요약.md.
11. 기존 사례 ② 상하이교통대 — 시뮬레이터에서 SmolVLA
스크립트 교사 572회 시연으로 SmolVLA를 학습해 한 장면에서 83.5 % · 단, 감독기와 특권 정보 포함
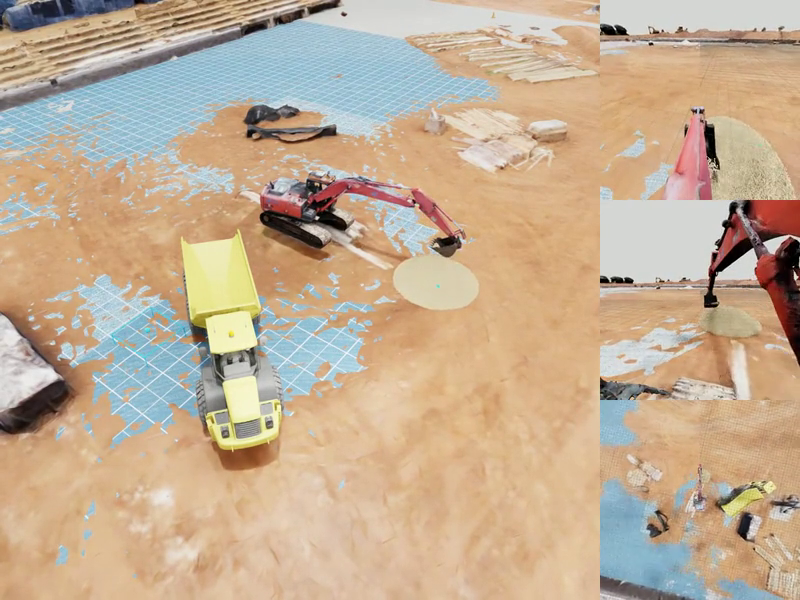 공개 평가 영상 30초 · 왼쪽 전체 시점 + 오른쪽 정책 카메라 3대 · 감독기를 켠 상태의 한 사이클
- 데이터
- Isaac Sim 입자 흙(약 4.5만 개) · 고정 차체 4축 · 흙더미를 아는 스크립트 교사가 10단계 굴착→트럭 적재 시연 · 품질 게이트 통과 572회 / 62,216 프레임
- 입·출력
- 카메라 3대(256²) + 고정 지시문 + 상태 27개(굴착 목표점·하역점·버킷 입자 수 포함) → 4축 관절 속도 50스텝 묶음, 앞 3스텝 실행
- 모델·학습
- SmolVLA(0.45B) · 시각 인코더 고정, 액션 전문가·상태 투영층·추가한 단계 분류 헤드 학습 · 567회로 학습 후 평가 장면 5회로 미세학습 · GPU 대여 약 1,540위안
- 결과
- 같은 장면 200회 중 167회 성공(83.5 %) · 성공 = 트럭에 입자 1개 이상 · 감독기 없이 다른 팀이 500 장면 재평가 시 58 %
- 한계
- 들기 이후는 규칙 기반 감독기가 관절을 대신 움직임 · 목표점이 상태로 주어짐(어디 팔지 선택 안 함) · 평가 장면 = 학습 장면 · 학부 캡스톤, 라이선스 없음
출처: lingxiao-yang.github.io/Excavator_VLA_project_overview · github.com/jxbb824/ExcavatorVLA (smolvla) · SJTU ME 450 Group 19, 2026 · 그림·영상 © 원저자(라이선스 미표기)
12
발표자 메모 · 근거
SJTU Global College ME 450 캡스톤 Group 19(2026 여름, 후원 Builder[x] Robotics, 지도 Prof. Qianli Chen). 시뮬레이터 Isaac Sim GPU PhysX, 물리 60 Hz/정책 10 Hz, 입자 약 45,000개, 고정 베이스 4자유도 URDF, 속도 명령 적분 → 강성 PD 위치 드라이브, 유압 없음. 교사: 특권 스크립트(7×7 격자 점수화로 굴착점 선택, 해석적 IK 10단계 pre_dig→…→unload_to_bin), 572개/62,216프레임. 학습: SmolVLA(SmolVLM2-500M 기반, 약 4.5억), 시각 인코더 고정, 액션 전문가·상태 투영층·단계 분류 헤드 학습, AdamW lr 5e-5, batch 144, 567 → seed 2 장면 5개 미세학습 → ckpt 18,450. 평가: seed 2 고정 장면 200회, 350스텝 상한, 3스텝마다 재계획, 감독기 켬 → 167/200. 상태 27D(레거시 v3: base_x/y/yaw, 월드 좌표, 버킷 입자 수 포함), 성공 기준 트럭 적재함 입자 ≥1. 후속 제3자(moonlightplague/ExcavatorVLA_new): 감독기 없이 ckpt 040000, 무작위 500 장면, 입자 ≥100 기준 290/500(58 %) — 같은 선에서 비교 불가.
가져올 것: 단계형 교사와 단계 라벨, 두 층 품질 게이트, 정규화 통계 SHA 핸드셰이크, 실패 분류 코드. 피할 것: 특권 입력으로 과제 쉽게 만들기, 감독기 성공을 정책 성공으로 보고, 평가 장면을 학습에 포함.
근거: docs/research/2026-11-07-sjtu-excavator-smolvla-capstone-analysis.md, 세션 인계문서 2026-11-08-sjtu-excavator-vla-session-handoff.md.
12. 파인튜닝 방법 — GR00T N1.7
시각·언어 모델은 고정, 로봇별 투영층과 확산 헤드를 학습
13
발표자 메모 · 근거
기반 nvidia/GR00T-N1.7-3B, embodiment 태그 new_embodiment(슬롯 10). 학습 대상: 상태 인코더·행동 디코더(투영층) + DiT 액션 헤드, tune_vlln=True. LLM·시각 인코더 고정. LoRA 아님. 데이터셋 LeRobot v2.1 + meta/modality.json + modality config. 행동 4D ABSOLUTE·NON_EEF, delta_indices 0~15, 132D 패딩(strict_action_padding_mask 검토).
근거: docs/research/2026-11-04-model-io-contract.md §7(c), Isaac-GR00T 공식 파인튜닝 문서(gr00t/configs/finetune_config.py: tune_llm False, tune_visual False, tune_projector True, tune_diffusion_model True; tune_vlln True. getting_started/hardware_recommendation.md: 파인튜닝 최소 40 GB+ GPU, 기본 설정 약 35 GB, LLM·ViT까지 풀면 80 GB+).
13. 파인튜닝 방법 — π0.5
두 큰 블록은 LoRA, 영상 인코더와 입출력 투영은 전체 학습
14
발표자 메모 · 근거
기반 pi05_base(gs://openpi-assets/checkpoints/pi05_base). 설정: gemma_2b_lora + gemma_300m_lora(이중 LoRA), 영상 인코더·action_in_proj/action_out_proj·time_mlp는 학습. 상태 discrete_state_input=True(256구간 → 프롬프트 토큰). 정규화 통계 compute_norm_stats로 사전 계산. 행동 32D 패딩 중 앞 4D 사용, action_horizon 16. 메모리 수치는 openpi 공식 README(openpi README 메모리 표: 추론 8 GB+, LoRA 22.5 GB+, 전체 70 GB+. 주의: 공식 config.py에는 pi05용 LoRA 설정이 없어 pi05=True + gemma_2b_lora/gemma_300m_lora + freeze_filter를 직접 조합해야 함).
근거: docs/execution/models/excavator-ft-entry.md L294–295·L604–606.
14. APEX에서 뽑는 데이터
ROS 2 토픽을 듣기만 하는 기록기로 받아 영상·상태·명령을 한 시각축에
15
발표자 메모 · 근거
APEX: Unity + AGX 입자 흙, HR35 디지털 트윈, ROS 2 Humble, 유압(plant) 끔. 토픽: /apex/sensor/camera/{cabin,boom}/rgb(+camera_info) 640×480 5 Hz, /apex/hr35/measured_joint_states(r06에서 96.3 Hz), /apex/hr35/plant_state(18/24 슬롯: 링크 각·차체 롤피치요·GNSS·등가 실린더 힘·(plant 켤 때) 압력), /apex/hr35/command [1,swing,boom,arm,bucket] ∈[−1,1], /clock, /tf. LiDAR cabin·boom → hr35_lidar_grid_mapper → /apex/grid_map/elevation 0.10 m, 미관측 NaN, 셀별 최소 높이 누적, 5 Hz.
기록: scripts/apex/observe.py(구독 전용, 원시 CDR + events.jsonl) → scripts/apex/convert_raw.py(카메라별 JSONL + 무손실 PNG) → LeRobot v2.1 변환기, 아직 잠금). 수집 계약: 5 Hz 기준, 10 Hz 명령, |u|≤0.2, 상태 q4+v4, 행동 요청 u4, 지시문 "move the bucket edge to the red ball".
근거: docs/execution/apex/runbook.md, configs/apex/observer-commanded-r12.json, docs/execution/apex/intermediate-contract.md, state-signal-mapping-proposal-2026-11-07.md, model-io-contract §13.
15. 시험할 데이터셋 — 세 단계
쉬운 것부터 · 버킷 이동 → 굴착 → 전체 사이클 · 공격점 선택은 확장
16
발표자 메모 · 근거
1단계 버킷 이동: 1-A 좌표+영상(연결·행동 출력 확인), 1-B 영상만으로 공 찾아가기(실패 시 모델 문제/과제 난이도 분리), 1-C 새 시작 위치·새 목표 평가. 현재 1-B·1-C 설계·분할 동결(20 에피소드), 수집 전.
2단계 굴착만: 교사가 관입·끌기·컬·들기로 나눠 단계 라벨 → 먼저 지시문으로 단계 주고 전환은 바깥 상태기계 → 다음 정책 하나가 전환까지.
3단계 전체 사이클: 덤프 위치 → 공격점 → 굴착 → 덤프 → 덤프 작업. 최종 보고 필수 아님(계획만).
확장: 공격점(POA) 선택까지 정책이. 지형 입력 필요 → 다음 장.
근거: handoff §4.2.
16. 공격점을 고르려면 지형이 보여야 한다
지형 높이 격자를 그림으로 VLM에 넣거나(길 A), CNN 토큰으로 상태에 붙이거나(길 B)
17
발표자 메모 · 근거
왼쪽 그림: APEX 관제 화면 실제 캡처(2026-11-13 사용자 제공, 두 번째 굴착 끝 장면). 왼쪽 세 칸 = 작업 설정 창의 지형 2D 격자 — 현재(라이다 실측 높이), 목표(편집한 목표 높이), 차이(목표 − 현재). 칸 0.15 m, 색 범위 −1 ~ +1 m, 회색 = 관측 없음, 초록 네모 = 흙을 팔 곳, 보라 네모 = 흙을 버릴 곳. 오른쪽 = 같은 순간의 Unity 시뮬레이터 화면. 캡처 6장(굴착 2회 × 시작·중간·끝) 중 1장을 잘라 썼고 원본 캡처는 수정하지 않았다. 이전 판의 RViz 화면·2026-09-10 높이 격자 변환 그림은 이 실제 관제 화면으로 바꿨다.
길 A: 부드러운 컬러맵 이미지를 세 번째 영상 슬롯에(π0.5 right_wrist 슬롯 / GR00T video 키 추가). 인코더 고정 → LoRA → 전체 학습 순. 이산 바둑판 이미지는 칸 경계를 무늬로 볼 위험.
길 B: 원 격자(현재·목표·차이 3채널) → 소형 CNN → 4×4 구역 토큰 16개를 모델 폭으로 투영해 토큰 줄에 추가. 공식 옵션 아님.
선형 프로브: 인코더 고정 + 선형층으로 교사 공격점 좌표 예측, 학습에 안 쓴 지형으로 평가(몇 시간 규모).
근거: handoff §4.4·§4.5, docs/execution/terrain/cpu-height-image.md, plan.md .
17. 첫 수집 데이터 — 교사 시연 20회
공 위치를 아는 교사 제어기가 움직이고, 기록기는 영상·상태·명령을 같은 시각으로 저장
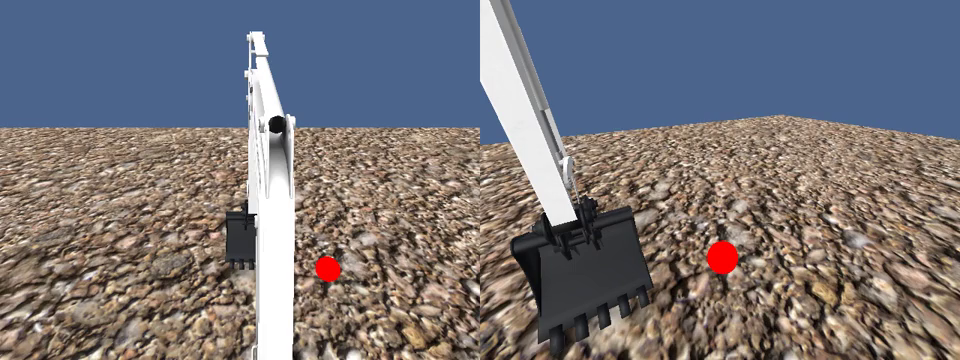 교사 시연 예 · 왼쪽 캐빈 위 카메라, 오른쪽 붐 아래 카메라 · 2배속 · VLA 아님
18
발표자 메모 · 근거
영상: (실행 기록)(교사가 명령, 정책은 기록만 하는 그림자 시험; 수집과 같은 교사·환경). 2배속으로 줄임. 수집 설계: configs/apex/splits/movement-v1-splits.json(수집 전 동결), 빨간 공 지름 0.3 m, 5 Hz, |u|≤0.2, 지시문 "move the bucket edge to the red ball". 품질 판정 D6~D9 규칙 적용 후 19/20 합격.
18. Lambda에서 파인튜닝한 과정
실패 원인을 하나씩 고쳐 GR00T 본 학습 완료 · 평가 오차 5.6배 감소
19
발표자 메모 · 근거
외부 GPU(Lambda H100 PCIe·SXM5)에서 GR00T 첫 학습 세션을 세 번 거쳤다. 1차: 환경 준비 통과, 한 번 갱신은 오프라인 모델 캐시 설정 오류로 실패 → 수정. 2차: 한 번 갱신 통과(배치 1 상태 dropout·bf16 재로드 검사 수정), 64회 과적합 검사에서 손실 −64.7 %지만 방향 일치 기준 미달(학습량 부족·정지 구간 75~92 % 분석). 3차: 본 학습 547회(20 epoch, batch 16, lr 1e-4 cosine, 약 23.5분), 평가 자료 MAE 0.1222 → 0.0695 → 0.0266 → 0.0218, 방향 일치 0.94/0.67/0.70/0.68, 0을 내는 기준 0.0346.
이후 같은 절차로 π0.5 첫 학습, 버킷 이동 2·3차와 공·콘 합본, 굴착 v2·v3 학습을 모두 외부 H100에서 했다.
근거: docs/execution/models/first-gr-session-result-2026-11-08.md, first-gr-g4-fit-analysis-2026-11-09.md, gr-second-session-result-2026-11-09.md.
19. 학습 후 첫 결과 — 버킷이 공까지 간다
11/09 파인튜닝한 GR00T 혼자 조종 · 학습에 안 쓴 위치에서 유효 3회 중 3회 도달
20
발표자 메모 · 근거
정책 단독 폐루프(교사 개입 없음, 모든 P 구간 명령 source=policy_g5 검증). 체크포인트 checkpoint-547(gr-second-01 G5). 추론: 로컬 RTX 5080 bf16, 공식 Gr00tPolicy + ZMQ(127.0.0.1), VRAM 약 6.4 GB, H100 평가와 MAE 0.02174 대 0.02177로 일치, 지연 p95 109.8~114.0 ms, 5 Hz 제어 경계 전 도착 15/15.
결과: P6-S2 d_min 0.307 m(16.2 s에 유지 충족), P7-S3 0.354 m(20.8 s), P7-S1 0.223 m(18.0 s; 1차 시도는 창 포커스 문제로 시작 전 실패 → 재실행). N=4, infra 1, n=3, k=3, Wilson 95 % [0.439, 1.0]. 위치 6·7은 dev 분할(학습 제외). 한계(11/09 당시): 분모가 작고, 시험 분할(test P2×4)과 π0.5는 이 시점 미평가 → 다음 장부터 이후 결과. 학습 전 0/72는 MuJoCo HR35 무학습 시험으로 환경이 다르다(직접 동일 비교 아님).
근거: (실행 기록), docs/execution/models/g5-policy-server-2026-11-09.md.
20. 버킷 이동 — 검증 위치 결과
모델을 바꿔 가며 다시 학습해도 위치 7 · 3번째에서만 반복 실패
π0.5 공·콘 ① · 위치 7·3 · 콘 실패
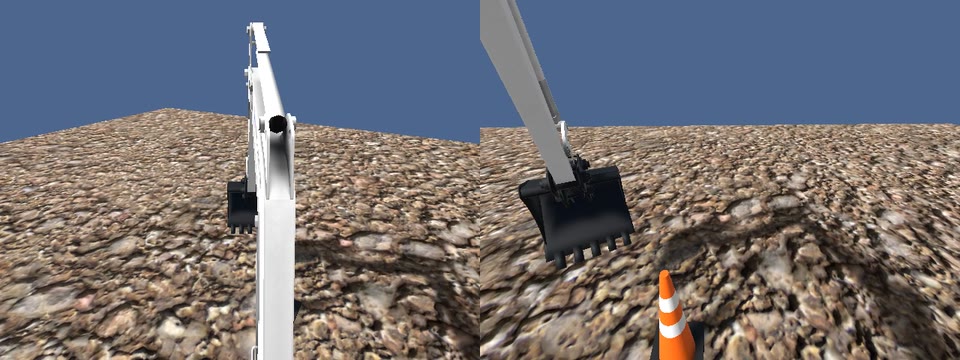
최소 거리0.65 m
팔을 거의 접지 않고 멈춤(공도 0.66 m 실패)공·콘 합본 = 빨간 공과 꼬깔콘 표적을 한 모델로 함께 학습
21
발표자 메모 · 근거
dev 3장면(P6-S2, P7-S1, P7-S3, 출발 거리 0.84–1.23 m) 장면마다 1회. 성공 = 모델 혼자 운전하는 약 12초 구간에서 버킷 끝과 표적 사이 0.5 m 안에 1초 이상 연속 + 0.3초 넘는 기록 공백 없음 + 끝난 뒤 정지 확인 + 명령 거부 없음.
π0.5 2차 P7-S3는 인프라 제외(참고 0.768 m). π0.5 공·콘 ② P7-S3 0.327 m는 원 판정이 '구간 안 사진 59장'으로 인프라였으나 구간 경계 계산 문제(최대 공백 0.23 s)라 '60장 이상' 보완 규칙으로 성공(그 전 run에는 사후 보완 규칙).
콘: π0.5 공·콘 ① 2/3(P7-S3 실패 0.647 m), ② 3/3(P7-S3 0.277), GR00T 공·콘 ② 3/3(P7-S3 0.252, P6-S0 0.042).
측정 조건: 로컬 RTX 5080 16 GB 1장(시뮬레이터와 모델 서버 공유), 드라이버 595.91.07, bf16, 10 Hz 명령·8단계 묶음 중 앞 4단계 실행·명령 크기 ±0.2, 정책 seed 7.
근거 정리본: docs/execution/results/2026-11-12-numbers.md §1.1, 비교표 docs/execution/apex/policy-eval-comparison-dev3-2026-11-09.md.
영상: 정책(모델) 구간만 잘라 재인코딩(960×360, h264), 원본 run 영상은 그대로 보존.
21. 버킷 이동 — 실패 원인과 보충 시범
원인은 출발 자세 빈칸 · 팔을 접는 시범 8개 보충 → 같은 위치 성공
π0.5 공·콘 ① 실패
첫 팔 명령 +0.040.65 m
π0.5 공·콘 ② 성공
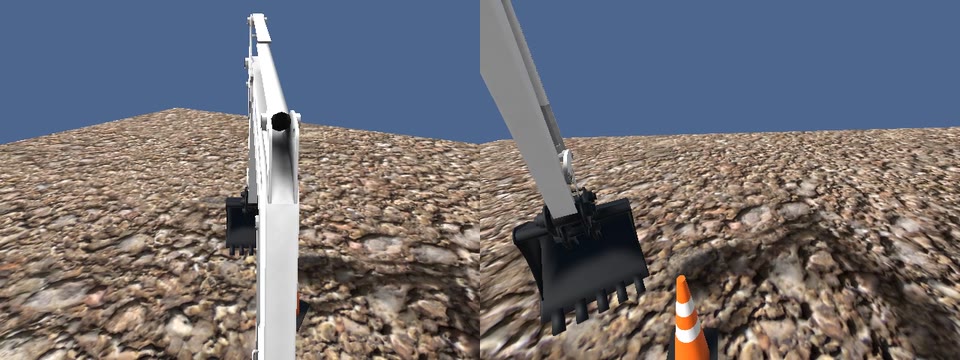
첫 팔 명령 −0.230.28 m
GR00T 공·콘 ② 성공
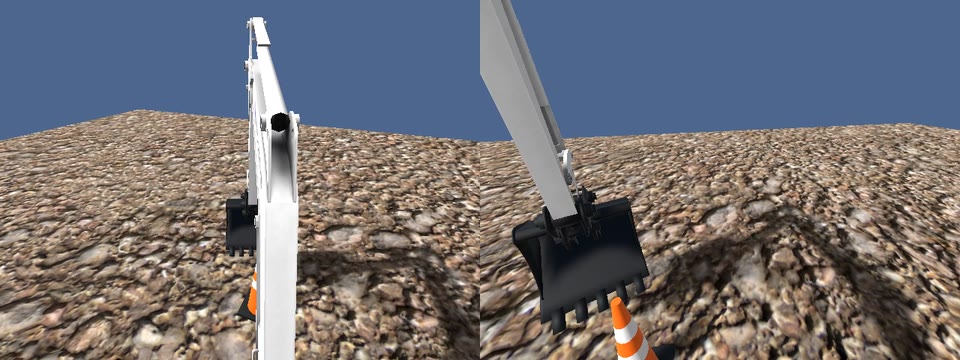
첫 팔 명령 −0.200.25 m
① 그 출발 자세의 학습 장면 17개 중 팔 접기 0개 · 관절 상태만 바꿔 넣으면 첫 명령이 접기로 바뀜(카메라 사진만 바꾸면 그대로)
② 교사(규칙 제어기, VLA 아님) 보충 시범 8개(4위치 × 공·콘) 추가 → 검증 위치 공·콘 두 모델 6/6
위치 7·3 · 꼬깔콘 표적(공도 같은 결과) · 붐 카메라 · 2배속 · 모델 구간만 · 보충 장면은 실패를 본 뒤 그 근처에서 골랐다(처음 보는 위치 일반화 근거 아님)
22
발표자 메모 · 근거
실패한 4 run(GR00T 3차·π0.5 3차·π0.5 공·콘 ① 공·콘)은 첫 명령부터 팔 명령이 0 근처이거나 펴는 쪽이었고 끝 팔 각도 0.62–0.67 rad. 교사는 출발 2.4초 동안 팔을 최대 속도로 접어 0.600 → 0.297 rad.
바꿔 넣기 시험(로컬 GPU, 2026-11-10): π0.5 공·콘 ①에 P7-S3 첫 관측을 넣고 관절 상태만 P7-S1 것으로 바꾸면 팔 첫 명령 +0.03 → −0.18 ~ −0.24(seed 3개 모두), 카메라 사진만 바꾸면 +0.03 ~ +0.07. 이 모델의 첫 명령은 화면이 아니라 출발 관절 자세로 정해진다.
보충 수집: S3 자세에서 가까운 표적으로 팔을 접는 교사 장면 8개, 8개 모두 학습 자료 판정 수락. 학습 자료 run 24 → 32, 학습 창 1,217 → 1,610, S3 자세 행 17 → 35(팔 접기 0 → 18).
실제 운전(P7-S3): π0.5 ① 공 +0.033 / 0.656 m 실패 → ② 공 −0.233 / 0.327 m 성공, ② 콘 −0.232 / 0.277 m 성공, GR00T ② 공 첫 명령 −0.200 / 0.251 m 성공. 팔은 여전히 교사만큼 접지 않는다(끝 +0.12–0.17 rad).
슬라이드 영상(2026-11-13 콘으로 교체): π ① 콘 첫 팔 +0.042 / 0.647 m 실패, π ② 콘 −0.232 / 0.277 m 성공, GR ② 콘 −0.200 / 0.252 m 성공(근거 2026-11-12-numbers.md §1.3 표, policy-eval-gr-joint-v2 §2).
측정 조건: 로컬 RTX 5080 16 GB 1장(시뮬레이터와 모델 서버 공유), 드라이버 595.91.07, bf16, 10 Hz 명령·8단계 묶음 중 앞 4단계 실행·명령 크기 ±0.2, 정책 seed 7.
근거 정리본: docs/execution/results/2026-11-12-numbers.md §1.2–§1.3, 분석 docs/execution/apex/p7s3-failure-analysis-2026-11-10.md.
영상: 정책(모델) 구간만 잘라 재인코딩(960×360, h264), 원본 run 영상은 그대로 보존.
22. 버킷 이동 — 최종 시험 위치
잠가 둔 시험 위치에서 GR00T 7/8 · π0.5 7/8 · 단, 출발이 표적 가까워 변별력 낮음
GR00T · 꼬깔콘 · 시험 위치 성공
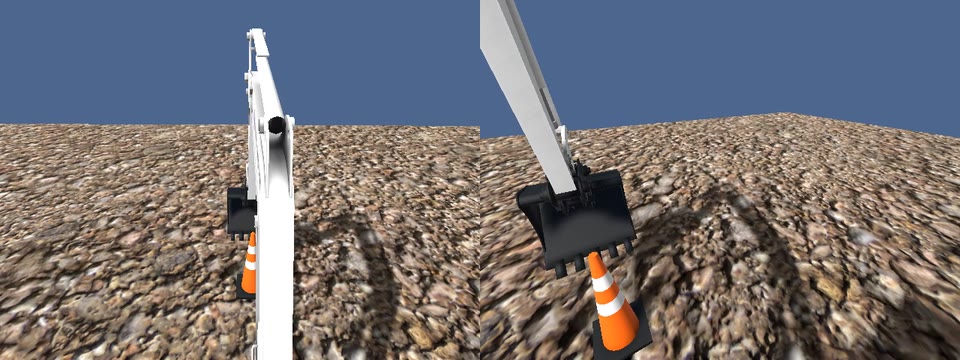
최소 거리0.30 m
π0.5 · 꼬깔콘 · 시험 위치 성공
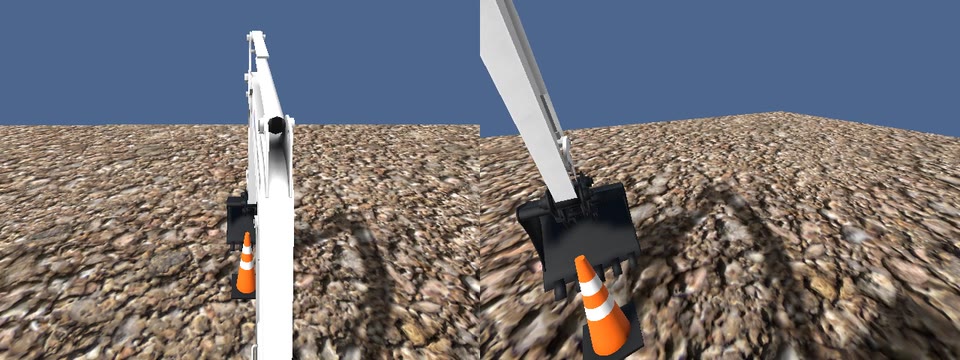
최소 거리0.18 m
GR00T · 꼬깔콘 · 위치 6 성공
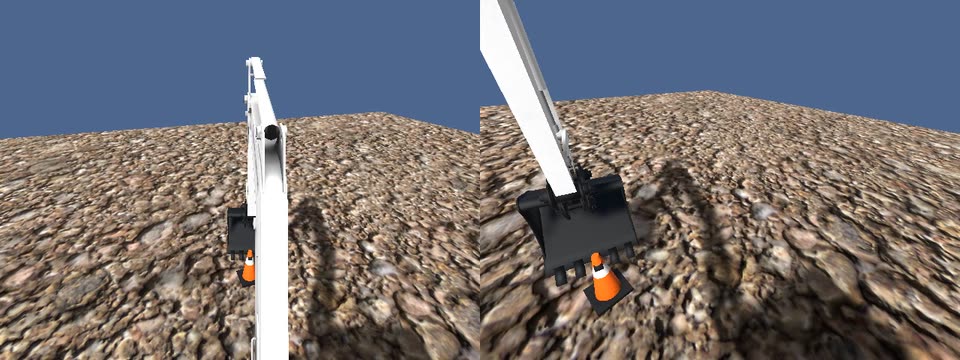
검증 위치 · 콘0.04 m
시험 결과(공 4 + 콘 4): GR00T 7/8(콘 1건은 끝난 뒤 관절 기록 0.54 s 공백으로 규칙상 실패) · π0.5 7/8(공 1건 화면 지연으로 제외)
시험 위치는 출발할 때 이미 표적과 0.24–0.56 m(검증 위치는 0.84–1.23 m) → “표적 근처에서 벗어나지 않는 능력”에 가깝고 두 모델을 가르지 못한다 · 붐 카메라 · 2배속 · 모델 구간만
23
발표자 메모 · 근거
최종 test(P2, 각 모델 공·콘 seed 4개씩 1회, 실행 전 고정 규칙).
GR00T 공·콘 ②: 공 0.234/0.198/0.293/0.330 4/4, 콘 S0 실패(버킷은 12초 내내 0.5 m 안·최소 0.24 m였으나 끝난 뒤 정지 확인 단계 관절 상태 메시지 0.54 s 공백, 허용 0.5 s → 규칙대로 실패) 0.203/0.302/0.323 → 7/8.
π0.5 공·콘 ②: 공 0.170/0.039/인프라(프레임 간격 99 % 값 78.4 ms, 기준 60 ms, 분모에 남김)/0.389 3/4, 콘 0.179/0.211(재실행: 무관한 예약 작업 CPU 사용으로 시작 전 멈춤)/0.325/0.241 4/4 → 7/8.
'아무것도 안 하는 정책' 기준선은 측정하지 않았다(미검증). 차이가 드러난 점(참고): GR00T는 60개 표본 중 51–60개를 0.5 m 안에, π0.5는 7–60개. 모델 응답 중앙값 GR00T 103–109 ms, π0.5 119–122 ms.
영상(꼬깔콘): GR00T 공·콘 ② 시험 S2 콘 0.302 m 성공, π0.5 공·콘 ② 시험 S0 콘 0.179 m 성공(이전 판의 공 영상 GR S2 0.293 m·π S1 0.039 m를 같은 결과의 콘 영상으로 교체, 2026-11-13). 세 번째 영상은 시험이 아니라 검증 위치 6 꼬깔콘(GR00T 공·콘 ②, 0.042 m).
측정 조건: 로컬 RTX 5080 16 GB 1장(시뮬레이터와 모델 서버 공유), 드라이버 595.91.07, bf16, 10 Hz 명령·8단계 묶음 중 앞 4단계 실행·명령 크기 ±0.2, 정책 seed 7.
근거 정리본: docs/execution/results/2026-11-12-numbers.md §1.4, docs/execution/apex/policy-eval-test-final-2026-11-10.md.
영상: 정책(모델) 구간만 잘라 재인코딩(960×360, h264), 원본 run 영상은 그대로 보존.
23. 버킷 이동 — 처음 보는 위치
어느 자료에도 없던 위치 2곳 · GR00T 4/8 · π0.5 6/8 · 높은 곳은 움직임이 모자람
π0.5 · 낮은 위치 · 콘 성공
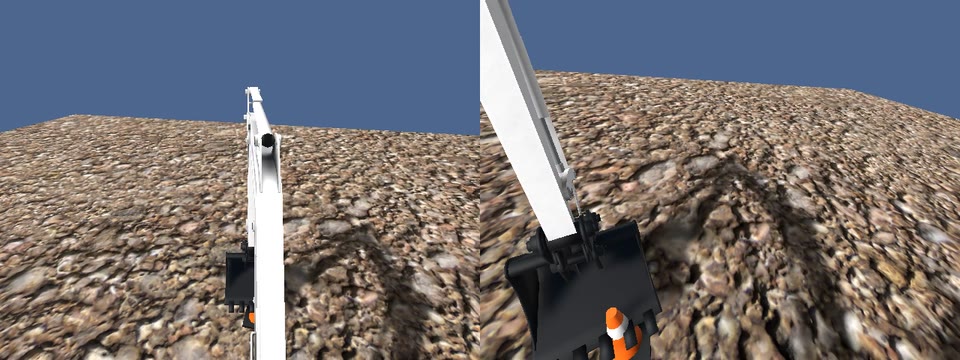
최소 거리0.11 m
π0.5 · 높은 위치 · 콘 실패
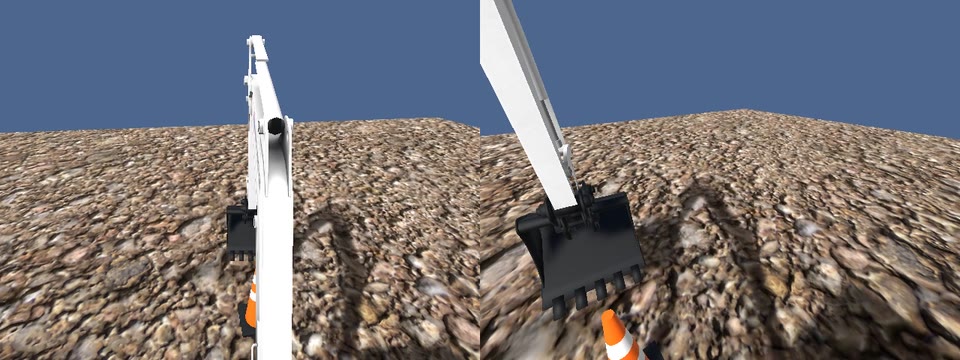
최소 거리0.49 m
꼬깔콘 표적 · 붐 카메라 · 2배속 · 모델 구간만 · 출발 거리 0.92–1.26 m
읽는 법
4/8 · 6/8GR00T · π0.5
- 방향은 처음 보는 위치에서도 대체로 맞다
- 크기가 모자람: 높은 위치에서 붐이 0.12–0.17 rad 낮고 팔이 0.25–0.32 rad 덜 접힘
- GR00T 실패 4건 중 2건은 끝난 뒤 기록 공백 → 거리만 보면 6/8 대 6/8, 우열 미확정
24
발표자 메모 · 근거
새 위치(실행 전 고정 규칙): P16 = 전방 2.5 m·오른쪽 0.5 m·높이 0.75 m, P17 = 전방 2.5 m·왼쪽 0.5 m·높이 0.35 m. 둘 다 학습 위치 사이(보간), 가장 가까운 기존 위치와 0.64 m. 학습 범위 밖(외삽) 후보는 시뮬레이터 점검을 통과한 것이 없어 시험하지 않음.
GR00T 공·콘 ②: 공 P16-S1 실패 0.494 / P16-S3 성공 0.426 / P17-S2 실패(정지 확인) 0.284 / P17-S3 성공 0.321, 콘 실패 0.490 / 실패(정지 확인) 0.424 / 성공 0.385 / 성공 0.298 → 4/8(거리 기준만 6/8).
π0.5 공·콘 ②: 공 성공 0.449 / 실패 0.528 / 성공 0.115 / 성공 0.135, 콘 실패 0.485 / 성공 0.454 / 성공 0.113 / 성공 0.080 → 6/8.
P16 성공 3번도 경계(0.43–0.45 m). 교사는 같은 곳을 2 mm까지 간다(오프라인 재현). 정지 확인 실패 3건은 모두 GR00T(관절 상태 0.51–0.80 s 공백, 관절은 실제로 멈춤, 원인 미확인).
영상(꼬깔콘, 2026-11-13 교체): π0.5 콘 P17-S2 성공 0.113 m, π0.5 콘 P16-S1 실패 0.485 m(이전 판은 공 P17-S2 0.115 m·공 P16-S3 0.528 m; 콘 P16-S3은 0.454 m로 성공이라 실패 예시는 S1). GR00T 새 위치 영상은 싣지 않는다.
측정 조건: 로컬 RTX 5080 16 GB 1장(시뮬레이터와 모델 서버 공유), 드라이버 595.91.07, bf16, 10 Hz 명령·8단계 묶음 중 앞 4단계 실행·명령 크기 ±0.2, 정책 seed 7.
근거 정리본: docs/execution/results/2026-11-12-numbers.md §1.5, docs/execution/apex/policy-eval-newpos-2026-11-10.md.
영상: 정책(모델) 구간만 잘라 재인코딩(960×360, h264), 원본 run 영상은 그대로 보존.
24. 굴착 — 네 동작으로 나눠 학습
관입 → 끌기 → 닫기 → 올리기를 동작별 지시문으로 한 모델에 학습
25
발표자 메모 · 근거
성공 기준(동작별, 실행 전 고정): 관입 = 끝 날 깊이 0.02 m 이상(최대 0.15 m 이하), 끌기 = 전진 0.25 m 이상 + 끄는 동안 날이 흙 속에 있던 비율 0.80 이상 + 끝 흙량 1.0 kg 이상, 닫기 = 버킷 각도 −130° 이하 + 흙 0.5 kg 이상이고 그때까지 최대량의 70 % 이상, 올리기 = 날이 흙 표면 위 1.2 m 이상 + 흙 80 % 이상 유지. 여기에 화면 기준까지 넘어야 '성공', 화면 기준을 못 넘으면 '판정 제외'(실패가 아님, 이 PC 시뮬레이터에서 검증 불가).
위치: 학습 위치(몸통 회전 0)와 검증 위치(+0.12 rad). v3 모델은 학습 위치(+0.10, +0.14)가 검증 위치를 양쪽에서 감싸 '보간'에 가깝다.
학습 자료: v2 = 흙 위치 3곳·학습 창 833, v3 = + 새 위치 12곳·학습 창 1,996(관입 882, 끌기 55 → 187, 닫기 332, 올리기 595), 끌기 창 3배 반복. 두 모델 모두 외부 H100에서 학습.
근거 정리본: docs/execution/results/2026-11-12-numbers.md §2.0·§2.3.
25. 굴착 — 첫 평가: 끌기에서 날이 뜬다
첫 평가 GR00T 2/4 · π0.5 1/4 · 끌기 4칸 모두 실패, 흙 실은 동작은 판정 불가
π0.5 · 끌기 · 검증 위치 실패
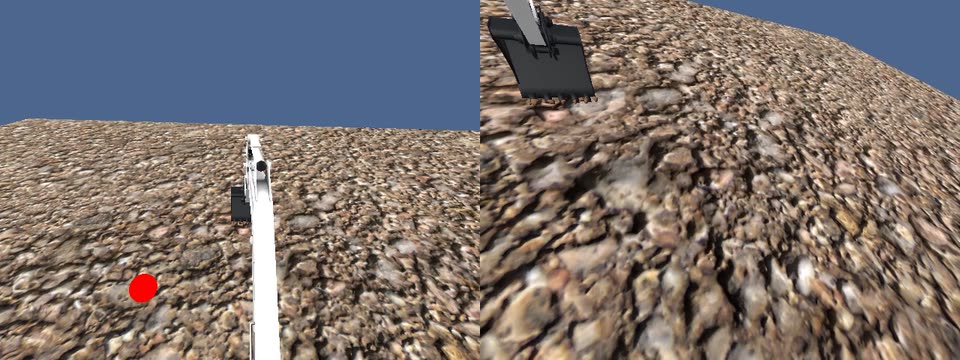
날이 흙 위로 뜸 · 흙 속 비율0.22
- 문제 ① 끌기 중간 날 깊이: 교사 +1.6~2.1 cm(흙 속) ↔ 모델 −2.5~−3.8 cm(흙 위)
- 문제 ② 흙을 실은 닫기·올리기에서 화면이 느려져 판정 제외
26
발표자 메모 · 근거
1차 동작별 폐루프(11/10, v2 모델, 판정 규칙 v3 사전 고정). 교사가 직전 동작까지 운전 → 그 동작만 모델이 운전.
관입: GR00T 학습 위치 판정 제외(정지 확인 실패), 검증 위치 성공 / π0.5 두 위치 성공. 끌기: GR00T 흙 속 0.46·0.23, π0.5 0.25·0.22 모두 실패. 닫기: 모두 판정 제외(화면 느림). 올리기: GR00T 검증 위치만 성공, 나머지 판정 제외.
통과 동작(두 위치 중 한 곳 이상 성공): GR00T 2/4(관입·올리기), π0.5 1/4(관입). 정책 동작만 본 기준(참고): 관입 5/5, 끌기 5/5 실패, 닫기 7/8, 올리기 7/7 통과. 연속 굴착 진입 조건(3/4) 미달.
측정 조건: RTX 5080, 595.91.07, bf16, 벽시계 화면 기준(동기 정지 전).
근거 정리본: docs/execution/results/2026-11-12-numbers.md §2.4–§2.5, docs/execution/apex/dig-closedloop-eval-v3-2026-11-10.md.
영상: 정책(모델) 구간만 잘라 재인코딩(960×360, h264), 원본 run 영상은 그대로 보존.
26. 굴착 — 보완 세 가지
자료 보강 · 시뮬레이터 동기 정지 · 명령 적용 일정 맞추기 — 재학습은 첫 번째뿐
1끌기 자료 보강새 흙 위치 12곳에서 교사 시연 수집 · 끌기 학습 창 55 → 187 · 끌기 3배 반복해 재학습
왜: 끌기 창이 다른 동작(215–294)보다 훨씬 적었다
오프라인 끌기 붐 오차 1/3–1/4로 감소
실제 끌기는 여전히 실패 → 3번으로
2시뮬레이터 동기 정지모델이 계산하는 0.12–0.2 s 동안 시뮬레이터 시간을 멈추고, 답이 오면 재개
왜: 같은 GPU에서 π0.5 계산 중 화면이 5–8배 느려짐 · 원격 추론은 왕복 0.94 s로 불가
멈춤 218회 모두 정상 · 닫기·올리기도 판정 가능해짐
3명령 적용 일정 맞추기왜: 학습 자료의 명령은 관측 0.07 s 뒤 것인데 시험 프로그램은 요청 0.2 s 뒤부터 적용 → 0번 칸이 늦어 붐을 더 올림 · 계산 중엔 시뮬레이터를 멈추므로 계산 시간 탓 아님
재학습 없이 끌기 8/8
27
발표자 메모 · 근거
보완 1(11/11): 새 흙 위치 12곳 교사 수집(14 run 모두 정상, 끌기 12/12 채택), 학습 창 833 → 1,996, 끌기 창 3배 반복(실행 전 고정). 검증 위치 끌기 붐 오차 GR00T 0.0192 → 0.0050, π0.5 0.0137 → 0.0056(오프라인 지표, 실제 굴착 성공을 뜻하지 않음).
보완 2(11/11): 모델 계산 중 시뮬레이터 시간 0배, 화면 기준 시계 = 시뮬레이터 시간(수치는 그대로). 같은 GPU에서 π0.5 계산 중 관입 화면 198 → 34장/초(GR00T는 약 1.5배 느려짐). 원격 추론 시험: 외부 H100(미국 서부), 모델 계산 0인 가짜 서버, 실제 굴착 사진 2장 150회 왕복 p50 938 ms·p99 1,569 ms(필요 0.2 s) → 불가.
보완 3(11/12): 모델이 낸 8칸 묶음(0.2 s 간격) 중 0번 칸을 건너뛰고 1번 칸부터 실행. 원인은 모델이 아니라 시험 실행 프로그램(발행기)의 명령 적용 일정과 학습 자료의 명령 시점 정의가 어긋난 연결 문제다: 학습 자료의 각 관측 정답은 '관측 70 ms 뒤에 나간 명령'인데, 시험 프로그램은 요청 직전 최신 화면으로 묶음을 받아 요청 0.2 s 뒤에 첫 칸을 적용 → 0번 칸 기준 약 0.13 s 늦고 1번 칸 기준 약 0.07 s 이르다. 굴착 시험은 모델 계산 중 시뮬레이터를 멈추는 동기식이므로 모델 계산 시간은 이 어긋남을 만들지 않는다(이전 판의 '추론 지연 보정'이라는 이름은 기전을 잘못 가리켜 고침, 2026-11-13). 모델 묶음은 교사와 거의 같음(붐 차이 −0.01 ~ +0.02)이나 0번 칸이 늦게 들어가 붐을 +0.016 ~ +0.035 더 올림. 모델 재학습 없음. 모의 실행에서 둘째 칸부터 실행 시 흙 속 1.0. 이 실행 방식은 끌기 실패를 본 뒤 골랐다(규칙 자체는 실행 전 고정).
주의: 첫 평가 → 재평가 사이에 모델(v2 → v3)·진행 방식(동기 정지)·화면 시계가 함께 바뀌었다. 개선을 한 가지 원인으로 돌리지 않는다. 재평가 → 끌기 보정은 실행 방식 하나만 바뀌었다.
근거 정리본: docs/execution/results/2026-11-12-numbers.md §2.5, docs/execution/models/dig-drag-improve-2026-11-11.md, docs/execution/apex/dig-eval-infra-2026-11-11.md, docs/execution/models/dig-drag-round2-2026-11-12.md.
27. 굴착 — 동작별 재평가
보완 1·2 적용 후 두 모델 모두 관입 · 닫기 · 올리기 통과 (3/4)
관입
닫기
올리기
GR00T3/4 동작
검증 위치 · 깊이 6.1 cm성공
검증 위치 · −132° · 13.0 kg성공
학습 위치 · 끝 18.3 kg성공
π0.53/4 동작
학습 위치 · 성공성공
학습 위치 · −133° · 14.4 kg성공
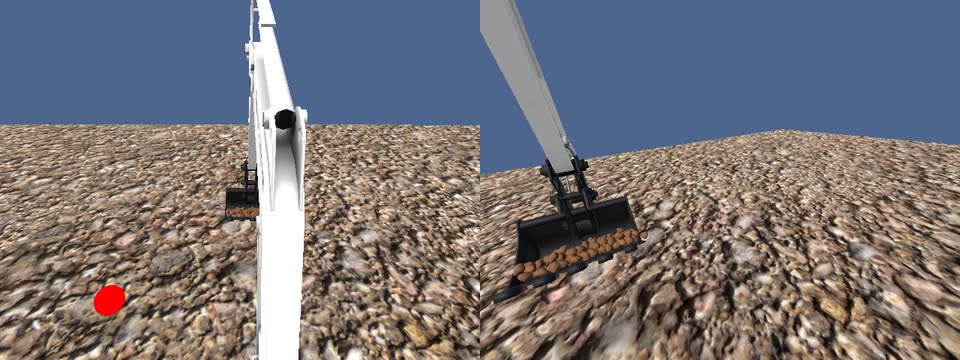
학습 위치 · 끝 17.8 kg성공
붐 카메라 · 작은 화면 = 모델 입력 화면(운전석 · 버킷 이동용 표적 공이 함께 보임) · 실제 속도 · 끌기는 아직 실패 → 다음 장
28
발표자 메모 · 근거
동작별 재평가(11/11, v3 모델, 동기식, 규칙 v4.2 실행 전 고정).
GR00T: 관입 학습 위치 성공(깊이 0.037 m)·검증 위치 성공(0.061 m), 끌기 실패(흙 속 0.33, 0.68 kg / 0.59, 1.94 kg), 닫기 학습 위치 판정 제외(흙 14 kg 물리 부하로 검증 불가)·검증 위치 성공(α −132.1°, 13.0 kg), 올리기 성공(끝 18.3 kg / 15.1 kg) → 3/4.
π0.5: 관입 학습 위치 성공·검증 위치 판정 제외(가드 감시 오류·메모리 압력 비상 정지), 끌기 실패(0.53, 0.95 kg / 0.75, 1.75 kg), 닫기 학습 위치 성공(α −132.5°, 14.4 kg)·검증 위치 판정 제외(19 kg 검증 불가), 올리기 학습 위치 성공(17.8 kg)·검증 위치 미실행(시작 전 여유 메모리 부족) → 3/4.
끌기 개선 정도: 구간 절반 날 깊이 −2.5 ~ −3.8 cm → −0.3 ~ −1.2 cm, π0.5 흙 속 0.22–0.25 → 0.53–0.75.
이전 판정과 나란히: GR00T 2/4 → 3/4, π0.5 1/4 → 3/4.
측정 조건: 로컬 RTX 5080, 드라이버 595.91.07, bf16, 동작당 모델 서버 1개. v4.2 이후 동기식(모델 계산 중 시뮬레이터 정지), 화면 기준은 시뮬레이터 시간으로 계산(정책 구간 초당 90장 이상·느린 1 % 프레임 60 ms 이하·사진 공백 0.3 s 이하). 모델·동작·위치당 유효 run 1개 → 위치 일반화·모델 우열을 주장하지 않는다.
근거 정리본: docs/execution/results/2026-11-12-numbers.md §2.6, docs/execution/apex/dig-closedloop-eval-v42-2026-11-11.md.
영상: 정책(모델) 구간만 잘라 재인코딩(960×360, h264), 원본 run 영상은 그대로 보존.
28. 굴착 — 끌기: 명령 적용 일정을 맞추자
원인은 모델이 아니라 시험 프로그램의 명령 적용 일정 · 재학습 없이 끌기 8/8
GR00T · 학습 위치
π0.5 · 검증 위치
보정 전11/11
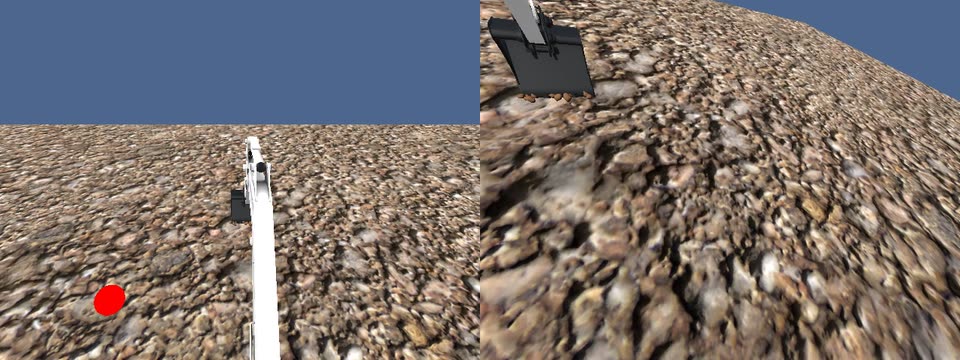
흙 속 0.33 · 0.68 kg실패
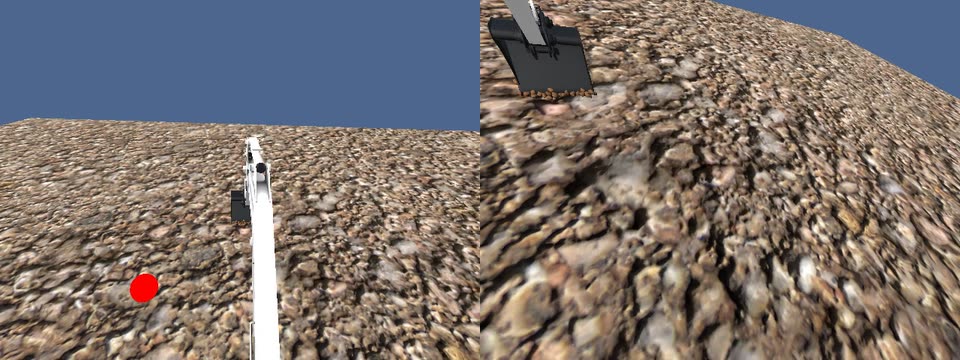
흙 속 0.75 · 1.75 kg실패
둘째 칸부터 실행
8/8끌기 성공
- 학습 자료 명령 = 관측 0.07 s 뒤 · 시험 적용 = 0.2 s 간격 일정 → 첫 칸이 늦음
- 두 모델 × 두 위치 × 실행 칸 수 2가지 · 흙 속 비율 1.0
- 재학습 없음 · 계산 중 시뮬레이터 정지라 계산 시간 탓 아님
보정 후11/12
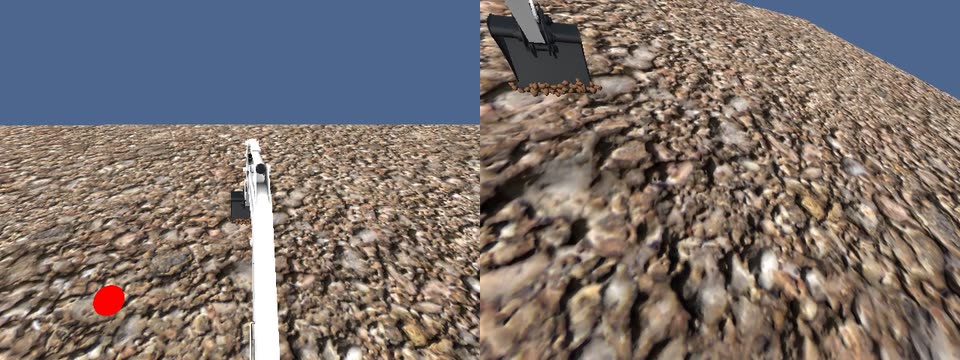
흙 속 1.0 · 3.83 kg성공
흙 속 1.0 · 5.50 kg성공
붐 카메라 · 작은 화면 = 모델 입력 화면(운전석 · 버킷 이동용 표적 공이 함께 보임) · 0.5배속 · 끌기 모델 구간만 · 앞 동작은 교사(VLA 아님) · 이 실행 방식은 끌기 실패를 본 뒤 골랐다
29
발표자 메모 · 근거
끌기 명령 적용 일정 맞춤 시험(11/12, 규칙 v4.2-k2 실행 전 고정, 판정 기준·판정기 동일; 이전 판 이름 '추론 지연 보정'은 기전을 잘못 가리켜 2026-11-13 고침). 실행 방식 2가지: 1–4번 칸 실행, 1·2번 칸 실행.
원인: 학습 자료의 명령 시점(관측 70 ms 뒤)과 시험 실행 프로그램의 적용 일정(요청 0.2 s 뒤 첫 칸, 0.2 s 간격)이 어긋남 → 0번 칸 기준 약 0.13 s 늦음, 1번 칸 기준 약 0.07 s 이름. 굴착 시험은 모델 계산 중 시뮬레이터를 멈추므로 모델 계산 시간 탓이 아니다. 근거 docs/execution/models/dig-drag-round2-2026-11-12.md B2, docs/research/2026-11-13-fieldfit-framework-critique.md §3.2.
단서: 둘째 칸은 실제 어긋남보다 0.07 s 앞선 명령이라 날이 더 깊이 들어갔을 수 있다 — '붐을 덜 올리게 하는 다른 치우침'으로도 끌기가 살았을 가능성을 가르는 시험(0.13 s 보간 적용 등)은 하지 않았다. 4칸·2칸은 같은 둘째 칸에서 시작해 독립 시행이 아니다(보수적으로 모델 × 위치 4조건 0/4 → 4/4).
결과 8/8: GR00T 학습 위치 흙 속 1.0·이동 0.255 m·3.83 kg(4칸) / 1.0·0.260·3.19(2칸), π0.5 학습 위치 1.0·0.259·5.58 / 1.0·0.263·3.18, GR00T 검증 위치 1.0·0.257·3.88 / 1.0·0.261·2.65, π0.5 검증 위치 1.0·0.261·5.50 / 1.0·0.260·5.83.
날 깊이 중간값 +1.3–2.4 cm(교사 +1.6–2.1 cm). 흙을 교사보다 더 담는다 — 다음 동작(닫기)의 흙 부하가 커지는 부작용. 4칸과 2칸 우열은 말하지 않는다(모델·위치·방식당 1 run). 끌기 단독 평가(교사가 관입까지 운전).
한계: 같은 위치 2곳에서 확인했을 뿐 다른 위치·장면 일반화 근거는 아니다.
측정 조건: 로컬 RTX 5080, 드라이버 595.91.07, bf16, 동작당 모델 서버 1개. v4.2 이후 동기식(모델 계산 중 시뮬레이터 정지), 화면 기준은 시뮬레이터 시간으로 계산(정책 구간 초당 90장 이상·느린 1 % 프레임 60 ms 이하·사진 공백 0.3 s 이하). 모델·동작·위치당 유효 run 1개 → 위치 일반화·모델 우열을 주장하지 않는다.
근거 정리본: docs/execution/results/2026-11-12-numbers.md §2.7, docs/execution/apex/dig-closedloop-eval-v42-k2-2026-11-12.md.
영상: 정책(모델) 구간만 잘라 재인코딩(960×360, h264), 원본 run 영상은 그대로 보존.
29. 굴착 — 연속 굴착
두 모델 모두 교사 없이 관입 → 끌기 → 닫기 → 올리기를 두 위치 완주 (각 2/2)
GR00T · 학습 위치 · 바깥에서 동작 전환 시연
GR00T · 검증 위치 · 스스로 동작 전환 시연
- 위 두 영상 = 밖에서 찍은 시연 녹화 · 공식 결과 아님 · 2배속
- 스스로 전환은 같은 조건 3회 중 2회 완주
- 공식 판정 = 아래 네 run · 흙 30 kg↑ 화면 느려짐 → ‘전체 시연 성공’으로 세지 않음
GR00T · 학습 위치 4/4
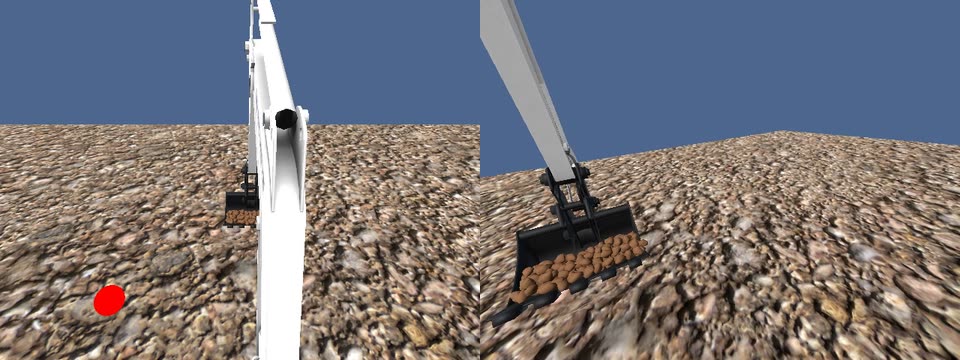
흙 31.8 kg동작 판정 4/4
GR00T · 검증 위치 4/4
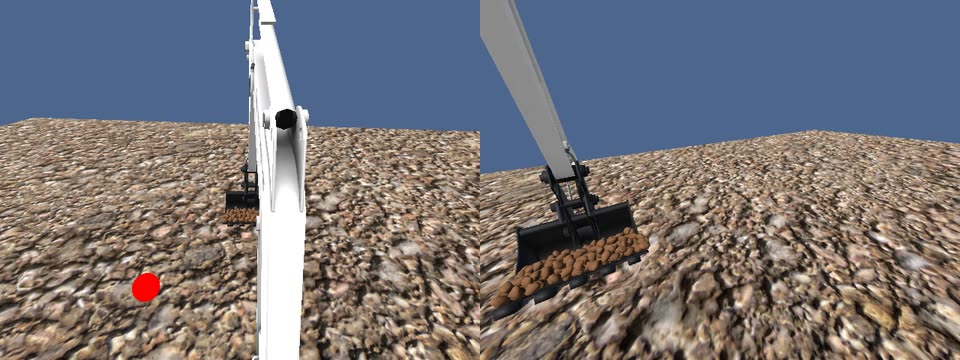
흙 32.7 kg동작 판정 4/4
π0.5 · 학습 위치 4/4
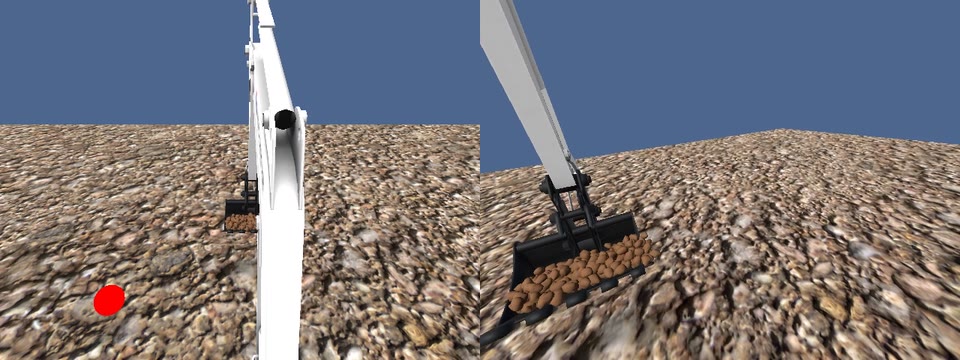
흙 42.0 kg동작 판정 4/4
π0.5 · 검증 위치 4/4
흙 48.0 kg동작 판정 4/4
아래 네 칸 = 공식 run의 붐 카메라 · 2배속 · 동작 넘김 신호만 바깥 프로그램 · π0.5는 시간 한도만 8 → 20 s
30
발표자 메모 · 근거
연속 굴착(11/12, 규칙 2단계 v3 실행 전 고정). 네 동작 모두 둘째 칸부터 실행. 흙 수치는 끌기 끝 → 닫기 끝 → 올리기 끝.
GR00T 학습 위치: 네 동작 끝 신호 4/4, 동작 판정 4/4 통과, 시간 전환 0, 최종(화면 기준 포함) 관입·끌기 성공·닫기·올리기 화면 기준 제외, 흙 7.1 → 30.4 → 31.8 kg. GR00T 검증 위치: 4/4, 4/4 통과, 시간 전환 0, 관입 성공·끌기·닫기·올리기 화면 기준 제외, 흙 8.9 → 30.3 → 32.7 kg.
π0.5(11/12 재실행, 규칙 v5 실행 전 고정 = 동기 정지 누적 상한 8 → 20 s, 끝 구간 회수 속도 틱당 10 → 40 ms만 변경, 정책 구간 명령 일정·판정 기준 불변): 학습 위치 네 동작 끝 신호 4/4·동작 판정 4/4 통과, 시간 전환 0, 관입 성공·끌기·닫기·올리기 화면 기준 제외, 멈춤 48회 합계 9.18 s, 끝 밀림 0, 흙 16.4 → 39.8 → 42.0 kg. 검증 위치 4/4·4/4 통과, 관입·끌기 성공·닫기·올리기 화면 기준 제외, 멈춤 48회 8.32 s, 끝 밀림 0, 흙 15.0 → 46.5 → 48.0 kg. 학습 위치 첫 시도는 시뮬레이터 에디터 시작 지연(정책과 무관)으로 시작 전 실패 → 규칙대로 1회 재시도.
이전 π0.5 시도(한도 8 s)는 판정 불가였다: 학습 위치는 끝 시간 보정 0.61 s 부족, 검증 위치는 올리기 도중 정지. 같은 설정의 GR00T 대조 실행 2회는 관측 사진 지연 연속 2회로 안전 정지(판정 불가) → GR00T 공식 결과는 첫 실행 그대로.
영상(2026-11-13 재배치, 사용자 결정 '외부 시점 위주'): 아래 네 칸은 공식 run 녹화의 붐 카메라만(운전석 카메라에는 버킷 이동용 표적 공이 함께 보여 뺐다). 위 두 칸은 외부 시점 시연 녹화(공식 결과 아님, 공 숨김): 왼쪽 = GR00T 학습 위치 바깥에서 동작 전환(공식 run과 같은 방식의 재현, 네 동작 판정 통과, 관입 깊이 4.0 cm), 오른쪽 = GR00T가 지시문 하나로 스스로 동작을 바꾼 검증 위치 run(네 동작 판정 통과·순서 정확, 관입 깊이 4.2 cm), 외부 카메라 1280×720 30 fps를 2배속 960×540으로 줄임, 공 숨김. 같은 조건 자체 전환 시연 누적 GR00T 3회 중 2회 완주. 외부 카메라는 모델 입력에 넣지 않음. 공식 판정 수치는 바뀌지 않음. 근거 docs/execution/apex/dig-self-switch-results-2026-11-13.md Part G.
규칙상 '전체 시연 성공'(네 동작 모두 최종 성공)은 두 모델 모두 아니다 — 이유는 모델 동작이 아니라 흙 30–50 kg에서의 시뮬레이터 속도(초당 20–33장)이다.
측정 조건: 로컬 RTX 5080, 드라이버 595.91.07, bf16, 동작당 모델 서버 1개. v4.2 이후 동기식(모델 계산 중 시뮬레이터 정지), 화면 기준은 시뮬레이터 시간으로 계산(정책 구간 초당 90장 이상·느린 1 % 프레임 60 ms 이하·사진 공백 0.3 s 이하). 모델·동작·위치당 유효 run 1개 → 위치 일반화·모델 우열을 주장하지 않는다.
근거 정리본: docs/execution/results/2026-11-12-numbers.md §2.8–§2.9, docs/execution/apex/dig-closedloop-part2-results-2026-11-12.md, docs/execution/apex/dig-part2-timing-ext-2026-11-12.md.
영상: 정책(모델) 구간만 잘라 재인코딩(960×360, h264), 원본 run 영상은 그대로 보존.
30. VLA 대 비VLA 기준선 — 같은 자료·같은 시험
언어를 읽지 않는 작은 모델 ACT도 대체로 비슷 · 처음 보는 위치·관입은 더 낮음 · 우열 일반화 안 함
| 시험 | GR00T | π0.5 | ACT (비VLA) |
|---|
버킷 · 검증 위치
공·콘 3위치 | 6/6 | 6/6 | 6/6 |
버킷 · 시험 위치
출발이 표적 근처 → 변별력 낮음 | 7/8 | 7/8 | 6/8 |
버킷 · 처음 보는 위치
ACT는 낮은 위치 4번 중 3번 실패 | 4/8 | 6/8 | 3/8 |
굴착 · 동작별 통과
ACT 관입 두 위치 실패 · 끌기는 둘째 칸 방식 | 4/4 | 4/4 | 3/4 |
연속 굴착 · 동작 판정
학습 위치 · 검증 위치 | 4/4 · 4/4 | 4/4 · 4/4 | 4/4 · 4/4 |
연속 굴착 · 화면 기준까지 성공
성공 동작 수 · 나머지는 판정 제외(검증 불가) | 2 · 1 | 1 · 2 | 4 · 3 |
연속 굴착 · 최대 흙
흙이 적으면 시뮬레이터가 덜 느려짐 | 32 · 33 kg | 42 · 48 kg | 20 · 13 kg |
모델 응답 시간(중앙)
같은 GPU | 103–109 ms | 119–122 ms | 14 ms |
읽을 때 주의
- ACT = 카메라 2대·관절 상태만 보고 명령 묶음을 내는 작은 모방학습 모델 · VLA 아님
- 모델·위치·방식당 run 1개 → 우열을 일반화하지 않음
- ACT 연속 굴착 ‘네 동작 성공’은 흙이 VLA의 절반 이하라 시뮬레이터가 덜 느려진 것 · VLA의 ‘판정 제외’는 실패가 아니라 검증 불가
- ACT는 응답이 7–9배 빨라 시뮬레이터 멈춤도 짧음
31
발표자 메모 · 근거
비VLA 기준선(11/13): 독립 비판 검토의 지적에 따라 VLA가 아닌 학습 정책을 같은 자료·같은 시험으로 학습·운전(live 33 run). ACT = 행동 묶음 + 트랜스포머 방식의 모방학습(2023 로봇팔 연구, 굴착기 연구 ExACT 2024도 사용).
버킷(성공 = 0.5 m 안 1초 + 정지 확인 + 공백 없음, VLA와 같은 60장 이상 규칙으로 재판정): ACT dev 공 0.089/0.210/0.289·콘 0.203/0.188/0.110 m → 6/6. test 공 0.227/0.331/0.508✕/0.063, 콘 0.243/0.185/0.546✕/0.164 → 6/8(S2만 벗어남). 새 위치 공 P16-S1 0.607✕/P16-S3 0.425/P17-S2 0.617✕/P17-S3 0.408, 콘 0.688✕/0.285/0.511✕/0.560✕ → 3/8. VLA와 달리 낮은 쪽 P17이 어려웠다(원인 미분석, 사후 참고).
굴착 동작별(v4.2 + 끌기 둘째 칸 방식): ACT 관입 학습 위치 깊이 0.019 m(기준 0.02) 실패·검증 위치 시간 초과 실패, 끌기 두 위치 흙 속 1.0(6.3·5.8 kg), 닫기 학습 위치 성공(−132.3°, 17.9 kg, 1회차 화면 느림으로 규칙 내 재실행)·검증 위치 판정 제외(두 번 모두 화면 기준 미달), 올리기 두 위치 성공(19.1·17.7 kg) → 3/4. VLA 4/4는 끌기 둘째 칸 방식(11/12)과 나머지(11/11)를 합친 같은 조합.
연속 굴착(규칙 2단계 v5): ACT 네 동작 끝 신호·동작 판정 두 위치 4/4, 시간 전환 0. 학습 위치는 화면 기준까지 네 동작 모두 성공(이 시험의 첫 ‘전체 시연 성공’), 검증 위치는 관입·끌기·올리기 성공·닫기 판정 제외. 그러나 ACT는 끌기 끝 흙이 13.0·9.8 kg로 VLA의 절반 이하라 정책 구간 화면이 초당 156·142장으로 덜 느려졌고, 추론 약 10 ms라 멈춤도 짧았다(41·43회). 이 차이를 모델 우열로 읽지 않는다. 연속 굴착 관입(둘째 칸 방식)은 성공했는데 동작별 관입(첫 칸부터)은 실패 — 실행 방식 차이로 보이나 확인 시험 없음.
응답 시간: ACT run별 중앙 13.8–31.4 ms(p95 최대 34.7), GR00T 103–109 ms, π0.5 119–122 ms.
인프라·재실행: 콘 P17-S2 1회(구간 사진 59장), 닫기 학습 위치 1회(화면 45.5장/초), 교사 관문 1회 더(규칙 내). 정책 실패는 재실행하지 않음.
측정 조건: 로컬 RTX 5080 16 GB(시뮬레이터와 공유), 드라이버 595.91.07, ACT fp32(버킷 25,000 step·굴착 35,000 step, 공식 기본 학습량의 약 35 %), VLA는 bf16. 같은 학습 자료·같은 카메라 2대 + 관절 상태 입력·같은 8칸 명령 묶음·같은 실행 방식과 판정기. ACT는 지시문 대신 과제 번호(버킷 공·콘, 굴착 네 동작)를 받는다.
근거: docs/execution/models/act-baseline-2026-11-13.md Part D(D1–D5), 결과 묶음 (실행 기록), VLA 수치 docs/execution/results/2026-11-12-numbers.md §1·§2.
31. 비VLA 기준선 — 영상으로 보기
ACT 연속 굴착 네 동작 성공(흙 20 kg) · 처음 보는 낮은 위치에서는 표적 앞에서 멈춤
ACT · 연속 굴착 · 학습 위치 네 동작 성공
흙 최대 20.0 kg · VLA는 32–48 kg화면 기준까지 4/4
π0.5 · 낮은 위치 · 콘 성공
최소 거리0.11 m
ACT · 같은 위치 · 콘 실패
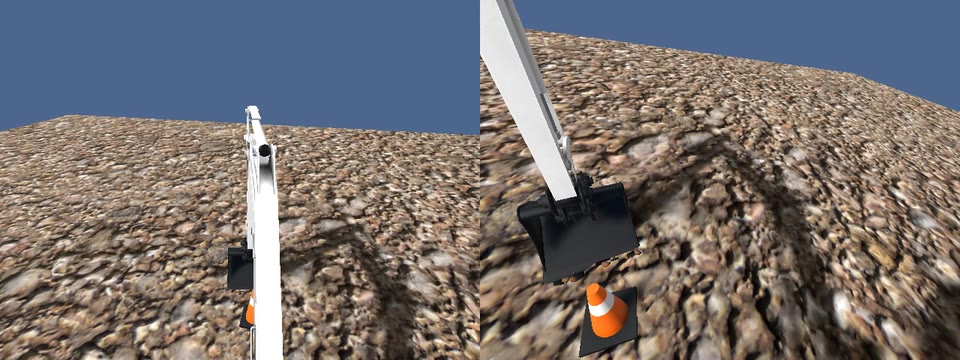
최소 거리0.51 m
처음 보는 위치 결과 GR00T 4/8 · π0.5 6/8 · ACT 3/8 · 오른쪽 두 영상은 같은 위치·같은 출발(붐 카메라 · 2배속) · 모델·위치당 run 1개 · ACT도 VLA가 아님 · 응답 ACT 14 ms 대 VLA 103–122 ms
32
발표자 메모 · 근거
왼쪽: ACT 연속 굴착 학습 위치(규칙 2단계 v5) — 네 동작 끝 신호 4/4, 동작 판정 4/4, 화면 기준까지 네 동작 모두 성공, 최대 흙 20.0 kg(끌기 끝 13.0 kg). 앞부분 준비 자세까지는 교사 운전(VLA·ACT 아님). 같은 장의 VLA 연속 굴착(앞 장)은 흙 32–48 kg에서 닫기·올리기가 화면 기준 판정 제외였다(실패 아님).
오른쪽: 처음 보는 위치 P17-S2(전방 2.5 m·왼쪽 0.5 m·높이 0.35 m) 꼬깔콘. π0.5 공·콘 ② 0.113 m 성공, ACT 0.511 m 실패(0.5 m 안 1초 유지 못 함; 같은 키 첫 run은 구간 사진 59장 인프라 → 규칙대로 1회 재실행한 run).
영상: 정책 구간만 잘라 재인코딩(960×360, h264), 원본 run 영상은 그대로 보존.
측정 조건: 로컬 RTX 5080 16 GB(시뮬레이터와 공유), 드라이버 595.91.07, ACT fp32(버킷 25,000 step·굴착 35,000 step, 공식 기본 학습량의 약 35 %), VLA는 bf16. 같은 학습 자료·같은 카메라 2대 + 관절 상태 입력·같은 8칸 명령 묶음·같은 실행 방식과 판정기. ACT는 지시문 대신 과제 번호(버킷 공·콘, 굴착 네 동작)를 받는다.
근거: docs/execution/models/act-baseline-2026-11-13.md Part D(D1–D5), 결과 묶음 (실행 기록), VLA 수치 docs/execution/results/2026-11-12-numbers.md §1·§2.
32. 관로 — 지도 보고 팔 곳 고르기 · 1단계
굴착 준비 자세까지 접근 9번 모두 성공 · GR00T는 한 번에 교사보다 많이 파냄
GR00T · 검증 지형 · 굴착 한 사이클 끝까지 수행
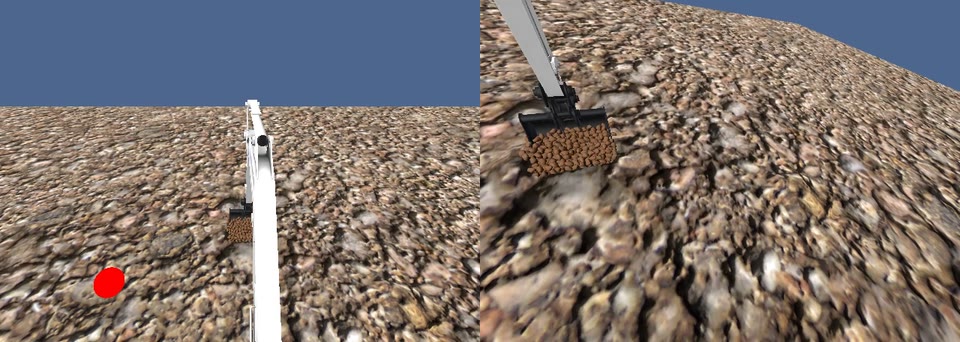
관로에 남은 흙0.048 → 0.025 m³
관로 = 기계 앞 3.3–4.7 m · 깊이 10 cm · 팔 곳(공격점)은 규칙(Jud 2017)이 계산 · 완결 측정 1번 · 교사는 일부러 얕게 팜 → 우열 근거 아님 · π0.5는 흙에 들어가다 멈춤
33
발표자 메모 · 근거
관로(트렌치) 과제(11/13–11/14): 기계 정면 전방 3.3–4.7 m·폭 0.5 m·깊이 0.10 m 관로를 판다. 다음에 팔 곳(공략점)은 Jud 외(2017) 규칙으로 정한다 — 목표면보다 3 cm 넘게 높은 칸 중 '높이 + 0.75 × 거리'가 최대인 칸에서 전방 0.10 m. 교사(규칙 제어기, VLA 아님)는 기존 한 버킷 굴착 자세를 그 위치로 옮겨 운전하고, 목표면 아래로 파지 않도록 진입 높이를 제한한다. 정책 입력 = 운전석·붐 카메라 + 지도 그림 1장 + 관절 상태 + 한 문장 지시. 정책이 접근 → 관입 → 끌기 → 닫기 → 올리기를 맡고 선회·덤프·복귀는 교사.
1단계(1차 학습 모델, 지도 1판 = LiDAR 높이 지도) 폐루프, 결과가 있는 run 9개: 두 모델 모두 접근 9/9 완료.
GR00T 검증 지형(팔 곳 4.25 m) 3회: 정상 완료 1회 = 접근·관입·끌기·닫기 통과, 올리기는 시간 안에 높이 미달(버킷 흙 40 kg), 관로 잔여 0.0480 → 0.0253 m³(−0.0227, 교사 같은 지형 −0.0093), 목표면보다 깊이 판 칸 0. 나머지 2회는 다섯 동작 모두 통과했으나 실행 끝 0.3초가 잘려 최종 지형이 없다(평가 실행 코드 결함, 수정함). 진입 위치는 팔 곳보다 0.12–0.16 m 가까웠다.
GR00T 다른 지형(팔 곳 4.65 m) 2회: 접근·관입·끌기 통과, 닫기 중 카메라 영상 지연(0.2–0.7초) 안전 정지, 진입은 팔 곳보다 0.65 m 가까움. π0.5 4회: 접근 통과, 관입이 시간 안에 끝나지 않음(깊이 0.3 cm 이하), 잔여 감소 0.0001–0.0009 m³.
단서: 완결 측정은 GR00T 1회뿐이고 교사는 바닥 보호로 일부러 얕게 파므로 'GR00T가 교사보다 굴착을 잘한다'는 근거가 아니다. 화면 속도 중앙값 70장/초(내부 기준 90 미만).
영상: 정상 완료 run의 두 화면 영상에서 모델 구간(접근 시작~올리기 끝 40 s)만 2배속, 위쪽 글자 띠를 잘라냄. 카메라 원본은 디스크 확보를 위해 삭제했고 이 영상이 유일본이다. 단면 그림: 관로 폭 평균 높이(시작 지형·교사 run 최종 지형·GR00T run 최종 지형 파일에서 계산).
측정 조건: 로컬 RTX 5080 16 GB(시뮬레이터와 공유), 드라이버 595.91.07, bf16, 동기식(모델 계산 중 시뮬레이터 정지), 8칸 중 둘째 칸부터 4칸 실행. 굴착 한 사이클 = run 하나, 사이클 사이 지형은 파일로 불러옴. 검증 지형 2개(팔 곳 4.25 m·4.65 m), 시험 지형은 잠근 채 미사용.
근거: docs/execution/models/trench-results-summary-2026-11-14.md(정본 요약), docs/execution/results/2026-11-14-numbers.md §8.
33. 관로 — 안 된 것과 교훈
지도 보고 팔 곳 고르기는 두 번 학습 모두 확인 못 함 · 들어간 곳은 늘 4.0–4.2 m
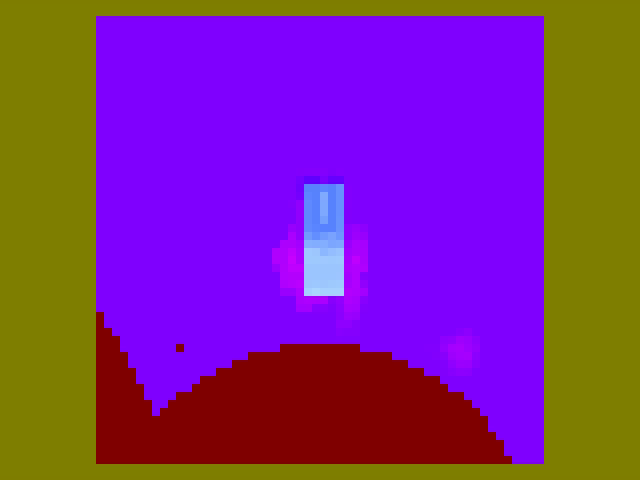
모델 입력 지도 · 1판 (넓게)
모델 입력 지도 · 2판 (관로 확대)
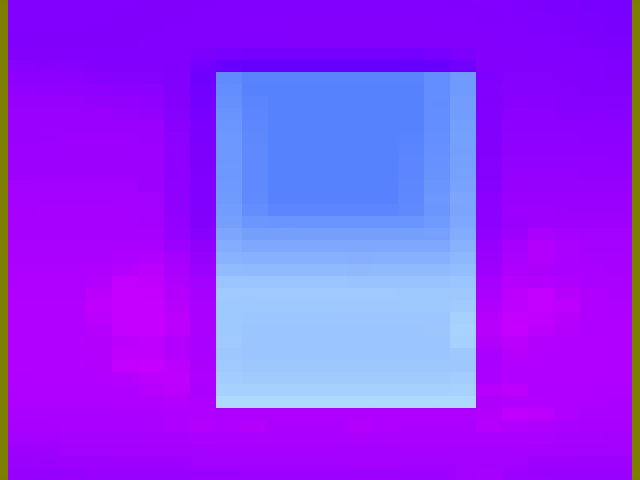
같은 지형 B · 가운데 띠 = 관로 · 밝을수록 덜 판 곳 · 팔 곳 표식은 넣지 않음(모델이 스스로 고르는지 시험)
① 장면만 봐도 답이 정해졌다
1차 자료는 지형 모습과 팔 곳이 한 쌍씩 묶임(값 5개) → GR00T는 본 지도만 외우고, π0.5는 지도 대신 카메라로 정함
② 지도를 키워도 연결이 안 생겼다
2차: 관로 확대 지도 + 같은 장면에 팔 곳만 다른 시연 추가(값 9개) → 지도만 바꿔 넣으면 진입 위치 이동 최대 4 cm
③ 추가 시연의 결함
새 시연 16번 중 12번은 교사 버킷이 흙에 닿지 않음 → 2차 모델은 4번 모두 흙에 들어가지 않음
다음 과제
팔 곳을 규칙이 계산해 숫자·표식으로 알려 주기 · 흙을 실제로 파는 시연으로 다시 수집 · 조건마다 반복 수 늘리기
34
발표자 메모 · 근거
지도 기반 위치 선택이 확인되지 않은 근거.
폐루프 진입 위치(진입 단계 마지막 버킷 날 끝의 전방 거리, 교사는 팔 곳 +0.006 m): 지형 A(팔 곳 4.25 m) — 1차 GR00T 4.11·4.13·4.09, π0.5 4.20·4.22, 2차 GR00T 4.12, π0.5 4.07. 지형 B(팔 곳 4.65 m) — 1차 GR00T 4.00·3.99, π0.5 4.15·4.16, 2차 GR00T 4.13, π0.5 4.17. 13회 모두 3.99–4.22 m.
지도 반사실(오프라인, 영상·관절 상태는 그대로 두고 지도만 다른 지형 것으로 교체, 예측 행동을 적분해 진입 끝 추정 — 교사 행동 적분은 실측과 2 cm 안 일치): 1차 모델 GR00T −0.06 ~ +0.08 m, π0.5 −0.01 ~ +0.02 m(방향 무관). 2차 모델은 학습 전에 기준을 등록 — 기준 1(팔 곳 차 0.2 m 이상인 지도 교체마다 차이의 50 % 이상 이동) GR00T 0/10·π0.5 0/10(최대 4 cm·1.3 cm), 기준 2(출발 순간 버킷 명령 부호) 12/16·12/16. 2차 폐루프 기준(두 지형 오차 0.15 m 이하)도 두 모델 실패(−0.125/−0.520, −0.183/−0.477 m).
원인 ①: 1차 접근 학습 12 run의 팔 곳 값은 5개(4.05–4.80 m, 평균 4.46)이고 같은 지형의 사이클 2·3이 같은 값 — 장면과 1:1. GR00T는 학습 지도에는 그 지도에 맞게 반응하고 처음 보는 검증 지도에는 무반응, π0.5는 지도와 무관하게 장면으로 결정.
원인 ②: 2차는 지도 2판(전방 3.0–5.0 m × 좌우 ±0.6 m 확대, 실행 시작 지형 파일에서 그림 — LiDAR 지도가 아님)과 추가 16 run(같은 장면에 팔 곳만 0.4 m 다르게)으로 접근 학습 36 run·값 9개. GR00T는 처음 보는 지도에도 출력이 달라지기 시작했으나 방향이 맞지 않음. 팔 곳을 직접 가르치는 신호(표식·숫자·보조 학습)는 넣지 않은 조건(사용자 결정: 스스로 고르는지 시험).
원인 ③: 추가 수집 지형은 팔 곳 바로 앞까지 목표 깊이로 미리 파 둔 형태라 교사의 바닥 보호가 진입 높이를 올림 — 교사 관입 최대 깊이 중앙값 기존 +0.6 cm, 추가분 −1.7 cm(지면 위), 흙에 들어간 run 16개 중 4개. 2차 모델 폐루프 4회 모두 관입 미완(버킷 날이 지면 위 1–8 cm). 인과는 한 번의 재학습에서 추정한 것(지도·자료·학습 횟수가 함께 바뀜).
말할 수 없는 것: 'VLA는 지도 기반 위치 선택을 할 수 없다'는 일반화(이 자료 규모·표식 없음·학습 1회씩의 조건), LiDAR 지도 입력 성능, 여러 사이클 연속 굴착. 평가 실행 코드 결함 3건(예열 요청 누락·끝 구간 지연 회수·판정 분류)은 1단계 중 고쳤고 2차 평가 4회는 장애 0.
지도 그림: 학습 자료의 지도 영상 첫 프레임(검증 지형, 팔 곳 4.65 m). 1판 아래 붉은 반원은 기계 밑(미관측).
측정 조건: 로컬 RTX 5080 16 GB(시뮬레이터와 공유), 드라이버 595.91.07, bf16, 동기식(모델 계산 중 시뮬레이터 정지), 8칸 중 둘째 칸부터 4칸 실행. 굴착 한 사이클 = run 하나, 사이클 사이 지형은 파일로 불러옴. 검증 지형 2개(팔 곳 4.25 m·4.65 m), 시험 지형은 잠근 채 미사용.
근거: docs/execution/models/trench-results-summary-2026-11-14.md(정본 요약), docs/execution/results/2026-11-14-numbers.md §8.
34. 관로 3차 — 교사를 고쳐 다시 학습
정해 둔 기준을 채운 모델은 없음 · 32번 중 4번은 실제로 흙을 파냄
GR00T · 통과한 실행 성공
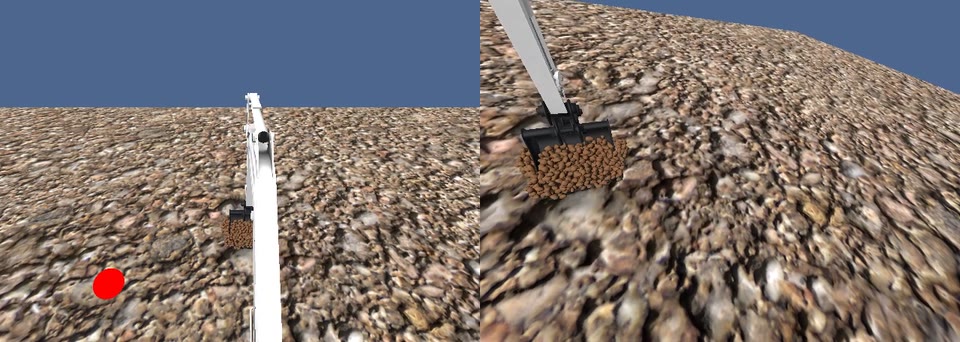
버킷에 담긴 흙36 kg
바꾼 것: 교사가 매번 흙을 파도록 수정 → 시범 60번 다시 수집 → 모델 8개(두 모델 × 표식 유무 × 시범 전체·절반) · 전체·절반 차이의 이유는 가르지 못함(학습 한 번씩)
35
발표자 메모 · 근거
관로 3차(11/14 밤 수집, 11/15 학습·평가). 1·2차에서는 교사(규칙 제어기, VLA 아님)가 미리 파 둔 자리에 내려가다 흙에 닿지 않은 시범이 많았다. 3차는 흙이 남은 자리만 진입 위치로 인정하고 진입 높이를 보정했다: 시범 60번(학습 56 + 검증 4) 모두 정상 완료, 모두 흙에 들어감(진입 최대 깊이 2.5–5.8 cm, 중앙 4.3 cm). 같은 장면에 진입 위치만 다른 쌍으로 모음(위치 값 13개).
구성: 지도에 진입 위치를 노란 띠로 그려 주는 구성(위치 판단은 규칙)과 표식 없는 구성, 시범 전체(55번·학습 창 7,531)와 먼저 모은 절반(27번·3,748, 무작위 표집 아님) → 모델 8개.
사전 등록 판정: 폐루프 구성 성공(한 모델이 두 지형 모두 과반 통과) 0건, 지도·표식만 바꿔 넣는 오프라인 기준도 8개 모두 미통과. 한 실행의 통과 조건 = 진입 끝 위치 오차 0.15 m 이내 + 진입 깊이 2 cm 이상 + 흙 제거량이 같은 지형 교사의 50 % 이상 + 과굴착·안전 정지 없음.
실행 통과: 시범 전체 모델 0/16, 절반 모델 4/16(GR00T 표식 2, GR00T 표식 없음 1, π0.5 표식 없음 1). 진입 동작 완료 1/16 대 9/16. 위치 조건 4/16 대 8/16. 표식 유무는 통과 2/16 대 2/16, 위치 조건 6/16 대 6/16.
통과 4번은 실제로 흙을 팠다(독립 검토가 지형 기록·흙 질량 기록으로 재계산): 흙 제거 0.0103–0.0267 m³(같은 지형 교사 0.0125–0.0129), 올리기 끝 버킷 안 흙 14.3–36.2 kg. 관로 완성 표시는 4번 모두 없음(한 사이클 부분 굴착).
측정 공백: 32번 중 13번은 실행 끝 지형이 저장되지 않아 흙 제거량이 없다. 그중 2번은 다섯 동작을 끝내고 버킷에 흙을 실었으나 통과로 세지 않았다(그림의 '흙 속 진입까지'에 포함).
전체 0/16 대 절반 4/16: 확인한 범위에서 시범 구성의 큰 차이는 찾지 못했으나, 학습 횟수(3,000 대 2,000회)가 다르고 학습이 조건당 1회라 자료량·학습 횟수·학습 우연을 분리하지 못했다. '시범을 줄이면 좋아진다'로 읽지 않는다.
영상: 통과 실행(GR00T 표식·절반, 진입 위치 4.15 m)의 두 화면 영상에서 모델 구간만 2배속, 위쪽 글자 띠를 잘라냄. 카메라 원본은 삭제(이 영상이 유일본).
측정 조건: 로컬 RTX 5080 16 GB(시뮬레이터와 공유), bf16(드라이버는 3차 평가 기록에 없어 미확인), 약 10 Hz 명령, 8칸 중 첫 칸을 건너뛰고 4칸 실행. 검증 장면 하나의 두 지형(진입 위치 4.15 m·4.55 m, 같은 장면에서 위치만 0.40 m 다름), 모델당 4회.
근거: docs/execution/models/trench-round3-plan-2026-11-14.md §11–18, 독립 검토 docs/execution/models/trench-round3-cause-review-codex-2026-11-16.md(다르면 독립 검토의 정정을 따름), 요약 docs/execution/models/trench-results-summary-2026-11-14.md §8, docs/execution/results/2026-11-14-numbers.md §8.5–§8.8.
35. 관로 3차 — 왜 흙에 못 들어갔나
진입 실패 22번 중 21번: 충분히 들어가기 전에 당기기 시작
GR00T · 실패한 실행 실패
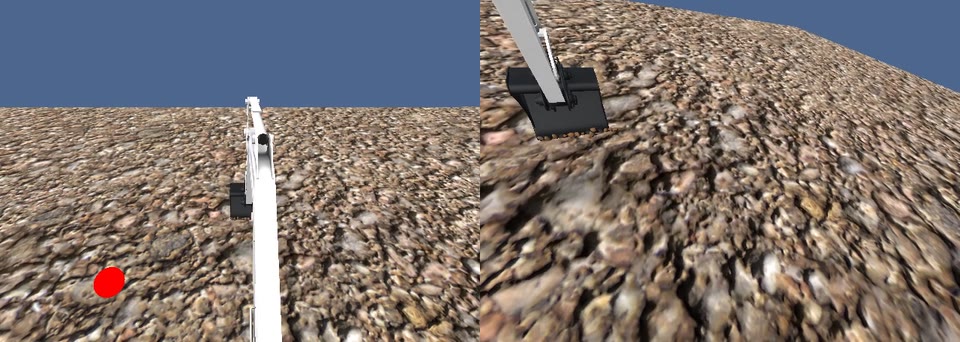
날이 표면에 닿자 당김빈 버킷
주된 실패 경로는 확인 · 원인 확정은 아님 · 다음: 교사가 깊이 넣고 머문 뒤 당기도록 고친 4차 재수집 진행 중
36
발표자 메모 · 근거
사후 분석(사전 등록 판정은 바꾸지 않음).
관측: 진입에 실패한 22번 중 21번에서, 진입 깊이(2 cm)를 확보하기 전에 당기는 방향의 명령(암 당김·붐 올림)이 이어졌다. 독립 검토가 원 명령 기록에서 다시 세어 같은 수를 얻었다. 진입에 성공한 10번 중에도 1번 있어 필요충분조건은 아니다. 나머지 실패 1번은 깊이 1.99 cm에서 머물다 시간 한도로 끝났다. 미통과 28번 = 진입 실패 22 + 진입 뒤 미통과 6.
당기기 시작한 순간의 깊이: GR00T(시범 전체) 중앙 0.0 cm, π0.5(시범 전체) 중앙 −5.5 cm(지면 위). π0.5는 더 일찍 멈추거나 팔 자세가 어긋나 지면 위에 머문 경우가 많았다.
교사 시범(검증 두 지형의 대표 2회, 실시간 추정 깊이): 당기기 1.0초 전 −0.4/−0.9 cm(지면 위), 0.8초 전 +0.7/+0.5, 0.5초 전 +2.2/+2.0, 0.3초 전 +2.9/+2.7, 당기는 순간 +3.7/+3.5 cm. 깊이 2 cm에 처음 닿은 뒤 당기기까지 0.50/0.39초. 그림은 두 번의 평균이다. 시범 55번 전체의 분포는 확인하지 않았다.
모델이 당기기 시작한 자세는 교사 궤적으로 치면 진입 끝 0–2.0초 전(GR00T 1.0–1.4초 전 — 그림의 붉은 띠, π0.5는 가까운 지형 0–0.8초·먼 지형 1.5–2.0초 전)에 해당한다.
단계 종료 기준 차이: 교사는 관절각이 목표에 수렴하면 다음 동작으로 넘어가고, 평가는 깊이 2 cm 이상 0.3초 유지로 진입 종료를 판정한다.
말할 수 없는 것: 원인을 확정했다는 것(교사 여유·모델의 진입 궤적 오차·실행 단계의 시간과 관측 차이가 함께 작용했을 수 있음), 교사를 고치면 해결된다는 것(저장된 궤적의 수식 재계산에서 21번 중 13–19번이 깊이 조건을 채우나 가정에 따라 달라지며 성공률 예측이 아님), 자료량의 효과. 모델이 화면에서 깊이를 보는지에 대한 시험은 모델 1개만 수행.
영상: 실패 실행(GR00T 표식·시범 전체, 같은 지형)의 모델 구간(접근 시작 ~ 진입 시간 한도) 2배속.
측정 조건: 로컬 RTX 5080 16 GB(시뮬레이터와 공유), bf16(드라이버는 3차 평가 기록에 없어 미확인), 약 10 Hz 명령, 8칸 중 첫 칸을 건너뛰고 4칸 실행. 검증 장면 하나의 두 지형(진입 위치 4.15 m·4.55 m, 같은 장면에서 위치만 0.40 m 다름), 모델당 4회.
근거: docs/execution/models/trench-round3-plan-2026-11-14.md §11–18, 독립 검토 docs/execution/models/trench-round3-cause-review-codex-2026-11-16.md(다르면 독립 검토의 정정을 따름), 요약 docs/execution/models/trench-results-summary-2026-11-14.md §8, docs/execution/results/2026-11-14-numbers.md §8.5–§8.8.
36. 원래 계획 대비 진행
확정 순서 0~6단계는 시뮬레이터 안에서 모두 한 바퀴 · 확장 과제는 진행 중
| 단계 | 원래 계획 | 11/15까지 결과 | 상태 |
|---|
| 0 모델 입출력 확인 | 공식 코드의 입력·출력 확인 | 구조·입출력 정리 → 굴착기 4관절 행동으로 연결 | 완료 |
| 1 LIBERO 로봇팔 추론 | 공식 가중치 실제 추론 | 두 모델 10/10 | 완료 |
| 2 버킷 이동(학습 전) | 가중치 그대로 굴착기에 적용 | 72회 중 0.5 m 도달 0회 → 학습 필요 | 완료 |
| 3 수집 환경 정비 | APEX · Isaac 재검토 | APEX 기록기·명령 경로·시뮬레이터 동기 정지 완성 · Isaac 미착수 | 일부 |
| 4 데이터 수집 | 교사 시연 → 학습 자료 | 버킷 공·콘 학습 run 32 · 굴착 흙 위치 15곳(학습 창 1,996) | 완료 |
| 5 외부 GPU 파인튜닝 | GR00T · π0.5 | 버킷 이동·굴착 모두 두 모델 학습 | 완료 |
| 6 굴착기 폐루프 재평가 | 학습 후 실제 운전 | 버킷 검증 6/6 · 시험 7/8 · 새 위치 4/8·6/8 · 굴착 동작별 3/4 · 끌기 8/8 · 연속 두 모델 2/2 | 완료 |
37
발표자 메모 · 근거
확정 실행 순서(2026-11-04 합의): 0 모델 입출력 확인 → 1 LIBERO 로봇팔 추론 → 2 굴착기 버킷 이동(학습 전) → 3 수집 환경 정비(APEX·Isaac 재검토) → 4 데이터 수집 → 5 GR00T·π0.5 외부 GPU 파인튜닝 → 6 굴착기 폐루프 재평가. 입력은 V1 RGB 다음 V2 LiDAR 그리드.
6단계 '완료'는 정해 둔 평가를 모두 실행했다는 뜻이며 목표 달성 전부를 뜻하지 않는다: 버킷 시험 위치는 변별력이 낮고, 새 위치는 높은 곳에서 움직임 크기가 부족하며, 굴착은 모델·동작·위치당 1 run, 흙 부하 구간은 화면 기준 판정 불가, π0.5 연속 굴착은 실행 시간 한도를 늘린 규칙으로 판정.
'굴착 스스로 전환'(2026-11-13): 검증 위치에서 GR00T·π0.5 모두 지시문 하나로 네 동작을 순서대로 완주(동작 판정 4/4, GR00T 관입·끌기 성공·닫기·올리기 화면 기준 제외, π0.5 화면 판정 불가), 학습 위치는 두 모델 모두 관입 정체. 시연 반복(공식 표와 별도): GR00T 검증 위치 3회 중 2회 완주, π0.5 3회 중 1회(완주 1회는 화면 판정 불가). 근거 docs/execution/apex/dig-self-switch-results-2026-11-13.md. 지형 지도 입력: LiDAR 지형 격자 시험 녹화 뒤 사용자 결정(11/13)으로 굴착 지점을 알려 주는 단계에서는 입력에서 빼고, 다음 굴착 위치를 스스로 정하는 단계(관로 과제, 11/13–11/14)에서 처음 넣었다. 결과: 두 모델 모두 접근 13회 완료, 1차 GR00T는 한 사이클에 관로 잔여 0.048 → 0.025 m³, 그러나 진입 위치는 팔 곳과 무관하게 4.0–4.2 m였고 지도만 바꿔 넣는 시험에서도 따라 움직이지 않음(학습 2회 모두). 1차 지도 = LiDAR 높이 지도, 2차 지도 = 실행 시작 지형 파일을 관로 주변만 확대한 그림(LiDAR 지도 아님). 근거 docs/execution/models/trench-results-summary-2026-11-14.md.
근거 정리본: docs/execution/results/2026-11-12-numbers.md §1·§2·§4.
37. 계획서의 연구내용은 이 실험으로 채워진다
시뮬레이터 결과로 연구내용 ①~③을 채우는 중 · 실차 2단계는 대리 실험으로 범위 명시
| 계획서 연구내용 | 계획서가 요구하는 것 | 이 실험에서 나오는 것 | 보고서에 쓰는 법 |
|---|
① VLA 모델 서베이
거의 확보 | π0.5·GR00T 2종의 입출력·데이터 요구량·제로샷/퓨샷 일반화 · 야외 필드 적합성 평가 기준 | 구조·입출력 분석 · 로봇팔 실측 지연·VRAM · 굴착기 제로샷 72회 · 기존 사례 2건 · 학습 후 두 모델 같은 기준 비교 | 7축 평가표에 실측값 기입 → 2종 비교표 v2 → 기술보고서로 등록 |
② 데이터셋 설계·시범 구축
시뮬 확보 | A-O Pair 정의·동기화 표준 · Co-training 전략 · 굴착 시범 데이터셋 1종(시뮬+실환경) | APEX 추출 신호·기록기 · 버킷 이동 공·콘 학습 run 32 · 굴착 네 동작 자료(흙 위치 15곳) | 정의서 + 데이터 카드 + 품질 게이트 결과 · 실환경분은 기존 실차 로그로 보강하고 범위 명시 |
③ 모델 적용 실험
시뮬 1단계 확보 | 1단계 시뮬 사전 검증 → 2단계 실차 테스트베드 · 제로샷 성공률 · 퓨샷 향상률 · 추론 FPS · 위치 오차 | 제로샷 0/72 → 버킷 검증 6/6 · 시험 7/8 · 새 위치 4/8·6/8 · 굴착 동작별 3/4 · 끌기 8/8 · 연속 두 모델 2/2 · 추론 약 0.1초 | 지표표를 시뮬 수치로 채움 · 실차는 APEX 고충실도 대리 실험 + 섀도 모드로 쓰고 미수행 명시 · 주행 과제는 범위 밖 |
④ 중장기 로드맵
기완료 | 실험 결과에 근거한 2027 전략사업 로드맵·기획서 | 데이터 효율·전이 갭·성공률 수치 | 기존 로드맵의 성능 목표 근거에 11월 수치 연결 |
⑤ 정량 성과
준비 | 논문 1건 투고 · 기술보고서 1건 · 소프트웨어 등록 1건 | 제로샷 실패 분석 + 파인튜닝 결과 · ①의 비교 보고서 · 변환·품질검사·평가 도구 | 논문: 실패 분석+학습 효과 · 기술보고서: ① · SW 등록: APEX→LeRobot 도구 |
계획서: (붙임1) 연구개발계획서 제3장 1·2·3절(연차목표 ①~④, 표 3-3·3-4·3-8) · 수행 방법 대응: 261022 재계획 총괄표
38
발표자 메모 · 근거
계획서(연구개발계획서_이한민_ff) 제3장: 연차 목표 (1) VLA 모델 야외 필드 적합성 심층 분석 (2) 필드 데이터셋 설계 및 시범 구축 (3) 모델 적용 실험(시뮬→실환경) (4) 중장기 로드맵·전략과제 기획. 성과지표: 모델 2종 비교분석, 데이터셋 1종, Sim→Real 2단계 검증 보고서 1건; 정량: 기타 논문 1, 기술보고서 1, SW 등록 1. 표 3-8 정량 지표: 제로샷 성공률, 퓨샷 성능 향상률, 추론 속도(FPS), 위치 오차. 계획서 대상 태스크에는 굴착 외 주행(Traversal)도 있었으나 현재 실험 범위는 굴착기 팔 작업(버킷 이동→굴착)뿐이다 → 보고서에 범위 명시.
대응 원칙(261022 재계획 총괄표): 7축 필드 적합성 평가표(실시간성·자원·행동공간·관측·데이터효율·강건성·개방성)에 시뮬 실측값 기입, 2종 비교표 → 기술보고서. 데이터셋: A-O Pair 정의서·동기화 규칙·품질 검사 도구, 시뮬 v0 → 실차 로그 보강 v1. 실험: 1단계 시뮬(Isaac/APEX) + 시뮬레이터 간 전이를 실차 전이의 대리 지표로, 실차는 R4 섀도 모드(추론만, 명령 미전송) 가능 시. 로드맵: 기완료, 11월 수치 연결. 정량 성과: 논문 11/17 전 투고, SW 등록 신청, 기술보고서 등록.
현재 상태(11/12): ① 두 모델 학습 후 같은 기준 비교까지 확보, ② 버킷 이동·굴착 시뮬 데이터 확보, ③ 버킷 이동·굴착 시뮬 폐루프 결과 확보(추론 응답 중앙값 GR00T 103–109 ms, π0.5 119–122 ms), ④ 기완료, ⑤ 준비. 근거 docs/execution/results/2026-11-12-numbers.md. 볼트 경로: 01_project/2026_기본사업_자체사업_필드로봇탐색연구/계획서_보고서_발표자료/.
38. 진행 중 · 다음 단계
스스로 동작 전환은 검증 위치 완주, 반복은 불안정 · 지도 보고 팔 곳 고르기는 세 번 학습, 기준 통과 없음
A굴착 스스로 전환지시문 하나로 관입 → 끌기 → 닫기 → 올리기
검증 위치: 두 모델 완주
학습 위치: 관입에서 멈춤
반복: GR00T 3회 중 2회 · π0.5 3회 중 1회일부 완료
B지도 보고 팔 곳 고르기지형 높이 지도를 넣은 관로 과제 · 세 번 학습
1·2차: 지도로 위치 고르기 미확인
3차: 32번 중 4번 굴착 · 기준 통과 없음
다음: 교사가 깊이 넣고 머문 뒤 당기는 4차4차 진행 중
CIsaac 재검토다른 시뮬레이터에서 같은 과제 재현미착수
39
발표자 메모 · 근거
11/11 실험 수치 마감(권고), 11/17 보고서·발표 내용 동결, 11/18 최종 발표.
A 근거 docs/execution/models/dig-self-switch-2026-11-12.md(설계: 한 지시문 + 이어진 교사 자료, 학습 창 1,996 → 2,192), 결과 docs/execution/apex/dig-self-switch-results-2026-11-13.md(검증 위치 두 모델 4/4 순서 정확, 학습 위치 관입 정체; 시연 반복 GR00T 3회 중 2회, π0.5 3회 중 1회 — π0.5는 관입 깊이가 실시간 기준 2 cm 근처에서 갈림).
B 근거 docs/execution/models/trench-results-summary-2026-11-14.md(관로 정본 요약: 접근 13회 완료, 진입 위치는 팔 곳과 무관, 지도 교체 시험 기준 미달, 2차 추가 시연은 교사가 흙에 닿지 않은 것이 대부분). 1차 지도는 LiDAR 높이 지도, 2차 지도는 실행 시작 지형 파일을 확대한 그림이라 LiDAR 지도 입력의 성능은 아직 말할 수 없다. 3차(같은 문서 §8, docs/execution/models/trench-round3-plan-2026-11-14.md): 교사 수정 뒤 재수집, 사전 등록 기준 통과 구성 0, 실행 통과 32회 중 4회(실제 흙 14–36 kg), 진입 실패 22회 중 21회가 깊이 확보 전 끌기 시작, 원인 확정 아님. 4차(교사 진입 방식 수정)는 진행 중이며 결과 없음. 이전 LiDAR 지도 시험 docs/execution/models/lidar-grid-v2-2026-11-12.md: 시험 녹화에서 지도-실제 높이 차 중앙값 0.0003 mm·상위 5 % 5.4 mm, 지연 p95 0.012 s. 그러나 관입·끌기·닫기 동안 판 자리가 버킷에 가려 2 cm 이상 파인 칸 0개(올리기 뒤 16개). 사용자 결정(2026-11-13): 굴착 지점을 외부에서 지정하는 현 단계는 입력 제외, 다음 굴착 위치·방법을 스스로 정하는 단계에서 필수 입력. V1/V2 재수집·학습 비교는 취소.
π0.5 연속 굴착 재판정은 완료되어 연속 굴착 장으로 옮겼다.